Lyrics MV Project: 소리, 서사, 코드가 한 점으로 수렴하기까지 (Compound Convergent Directing 회고록)
– ArtXTech
Lyrics MV Project: 소리, 서사, 코드가 한 점으로 수렴하기까지
스마트폰 디스플레이의 픽셀 하나를 고치기 위해, 혹은 DAW에서 뭉개지는 250Hz 영역의 혼탁함을 잡기 위해 밤을 새워본 적이 있는가?
내 Lyrics MV Project는 단순히 가사 위에 예쁜 모션을 얹는 작업에서 시작하지 않았다. 보컬 커버, 믹스와 마스터링, 자막 데이터, WebGL 셰이더, 키네틱 타이포그래피, 서브컬처 서사, 그리고 프레임 단위 렌더링을 하나의 파이프라인으로 묶는 1인 총체예술 실험에 가까웠다.
나는 이 작업 방식을 Compound Convergent Directing(이런 타이틀은 존재하지 않는다. 당연하지. 내가 만든 말이니까) 라고 부른다. 서로 아무 상관 없어 보이던 데이터 분석, 오디오 엔지니어링, 프론트엔드 개발, 팬아트, 모션 디자인이 결국 하나의 MV로 수렴하는 구조다.
1. 프로젝트의 출발점: 리릭스 MV를 하나의 시스템으로 보기
내가 만들고자 한 것은 매번 처음부터 다시 만드는 영상이 아니었다. Biiip by Xlov, BTTF by NCT Wish, Bye My Monster by ONF, Chroma Drift by Plave, 그리고 Niji by L’Arc-en-Ciel 커버 작업을 거치며 반복되는 제작 단계를 하나의 시스템으로 축적하고 싶었다.
처음에는 웹 페이지 애니메이션을 만들었다. 이후 이를 Remotion 기반의 30fps 비디오 렌더링 구조로 전환했다. SVG Filter, CSS3 Blending Mode, WebGL, Three.js, React Three Fiber, SRT 기반 자막 데이터, Figma 스토리보드가 차례로 파이프라인에 들어왔다.
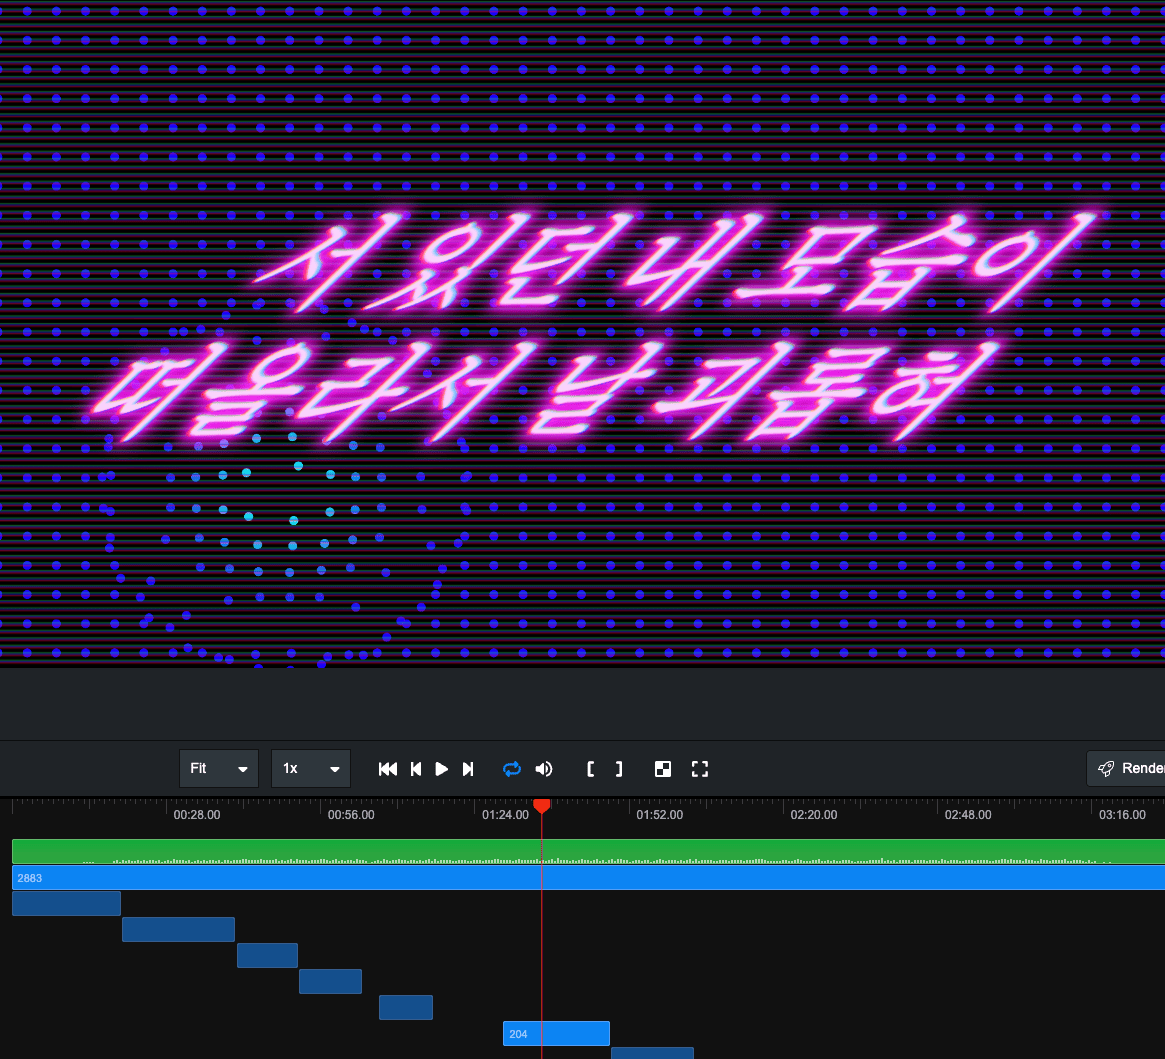
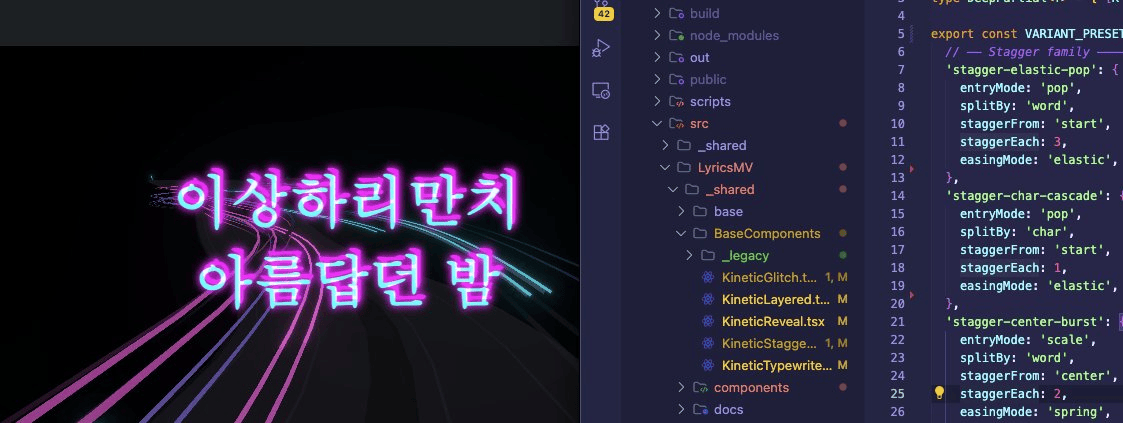
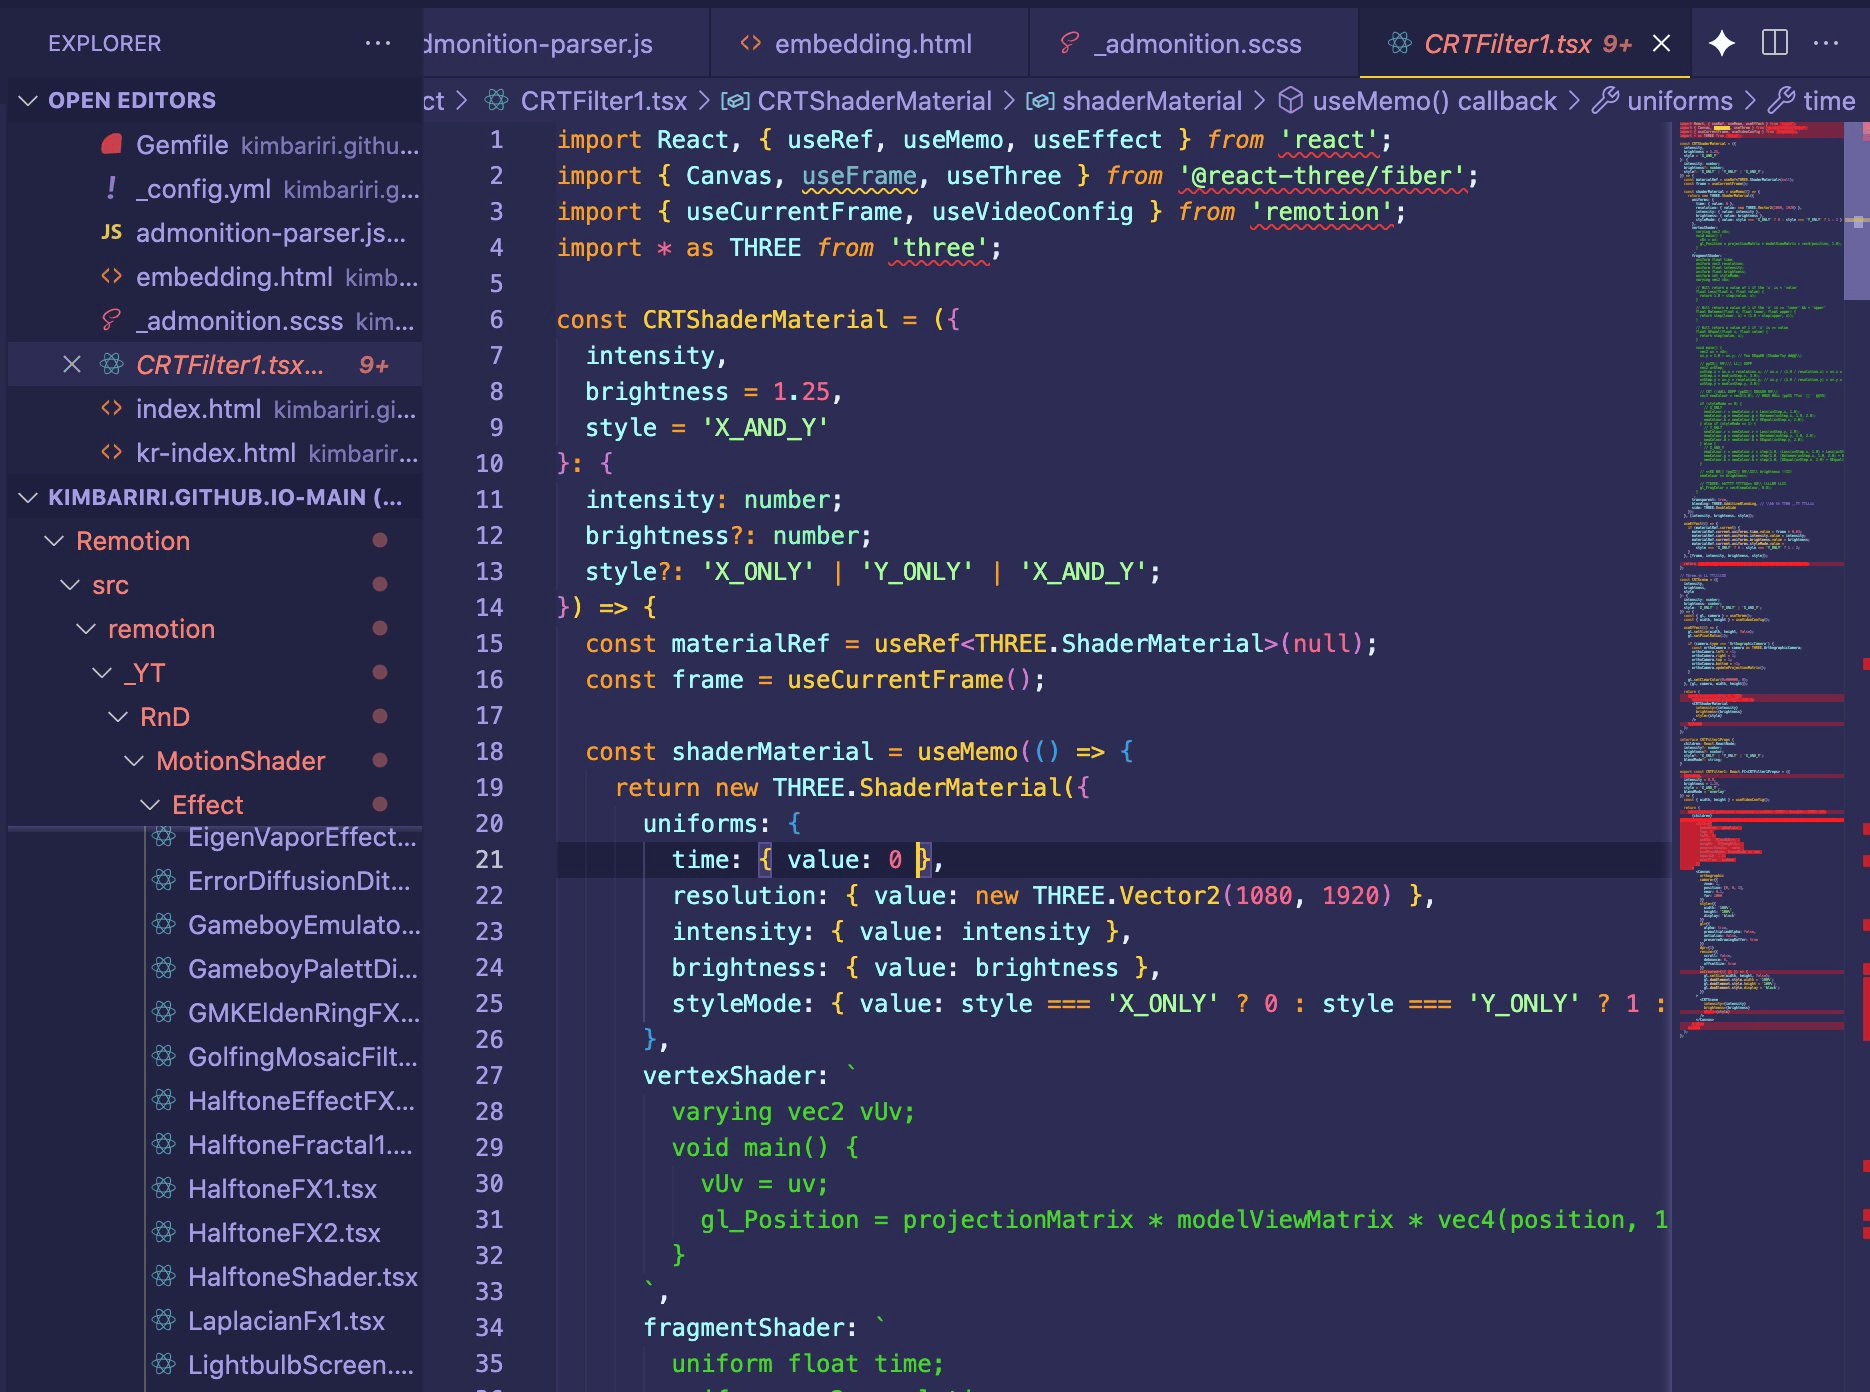
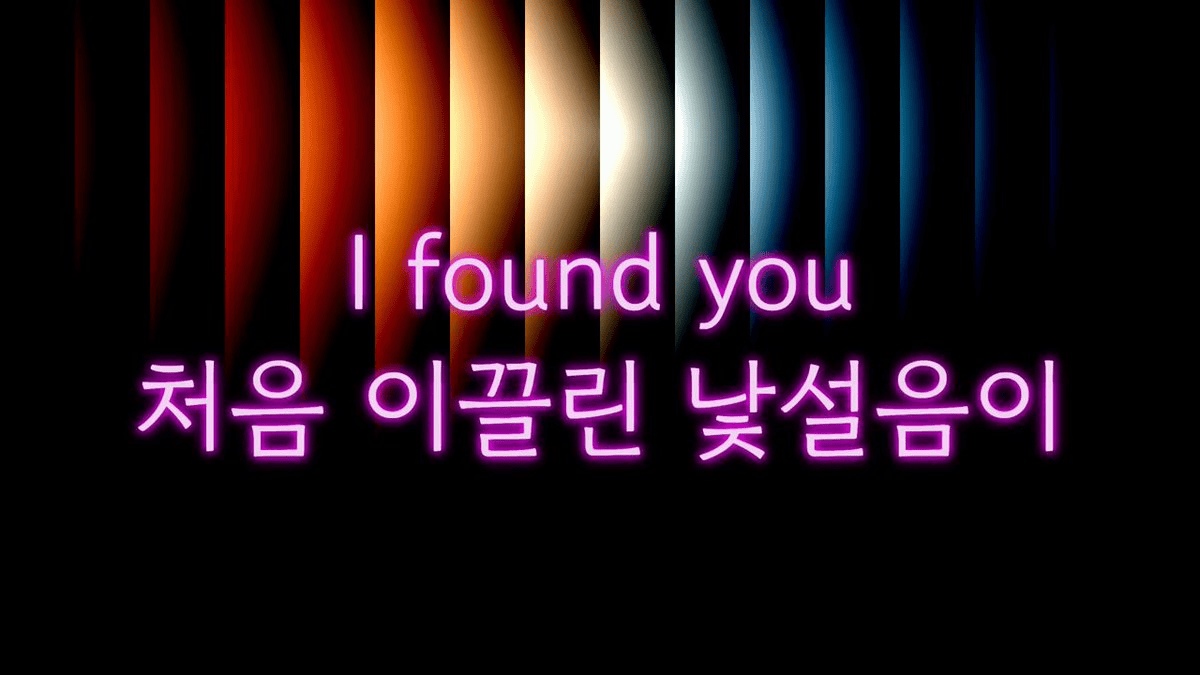
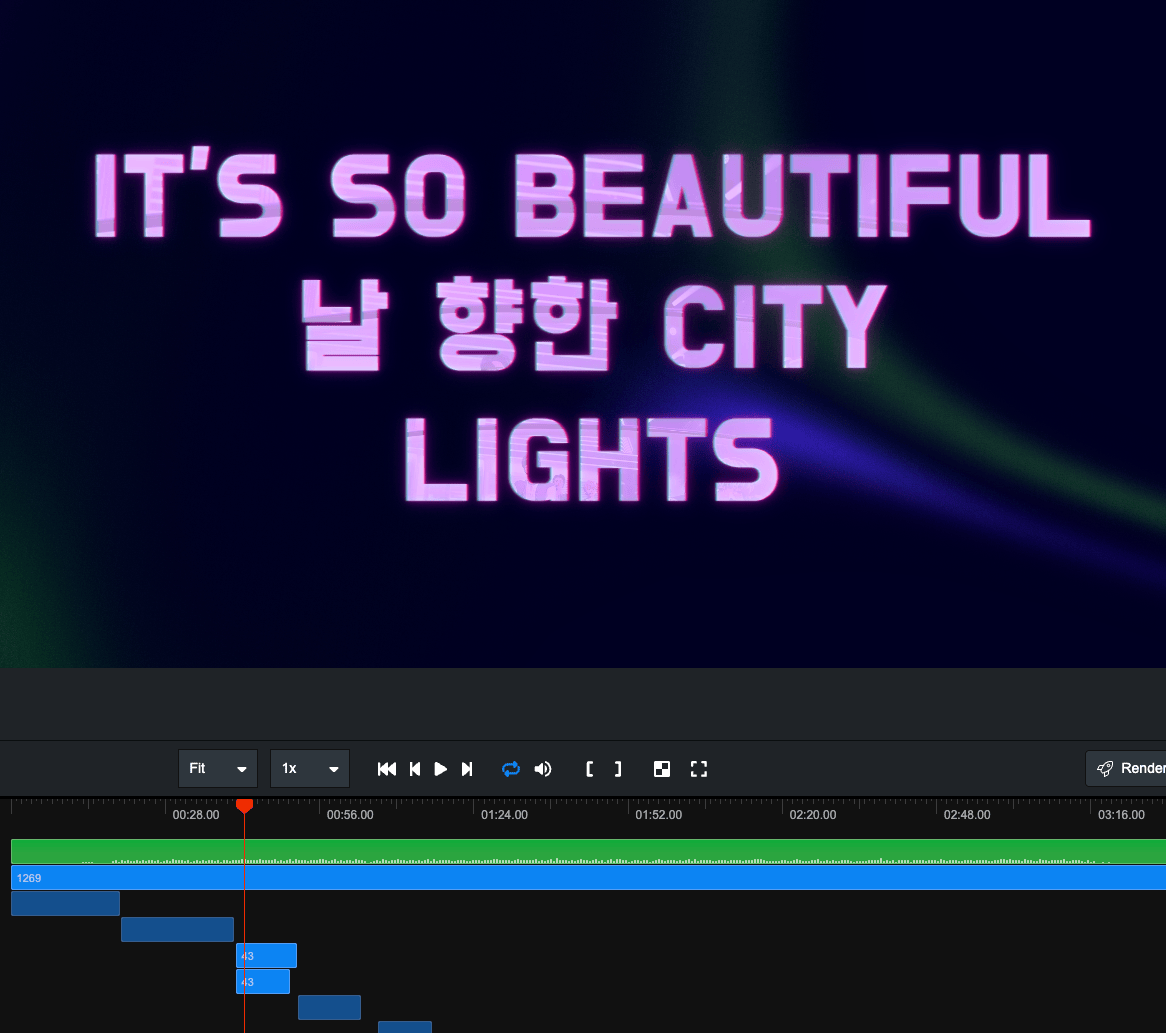
첫 번째 리릭스 비주얼라이저는 일종의 프로토타입이었다. 당시에는 원곡을 리믹스하는 수준이었지만, 가사 데이터와 시각 컴포넌트를 코드로 연결할 수 있다는 가능성을 확인했다.
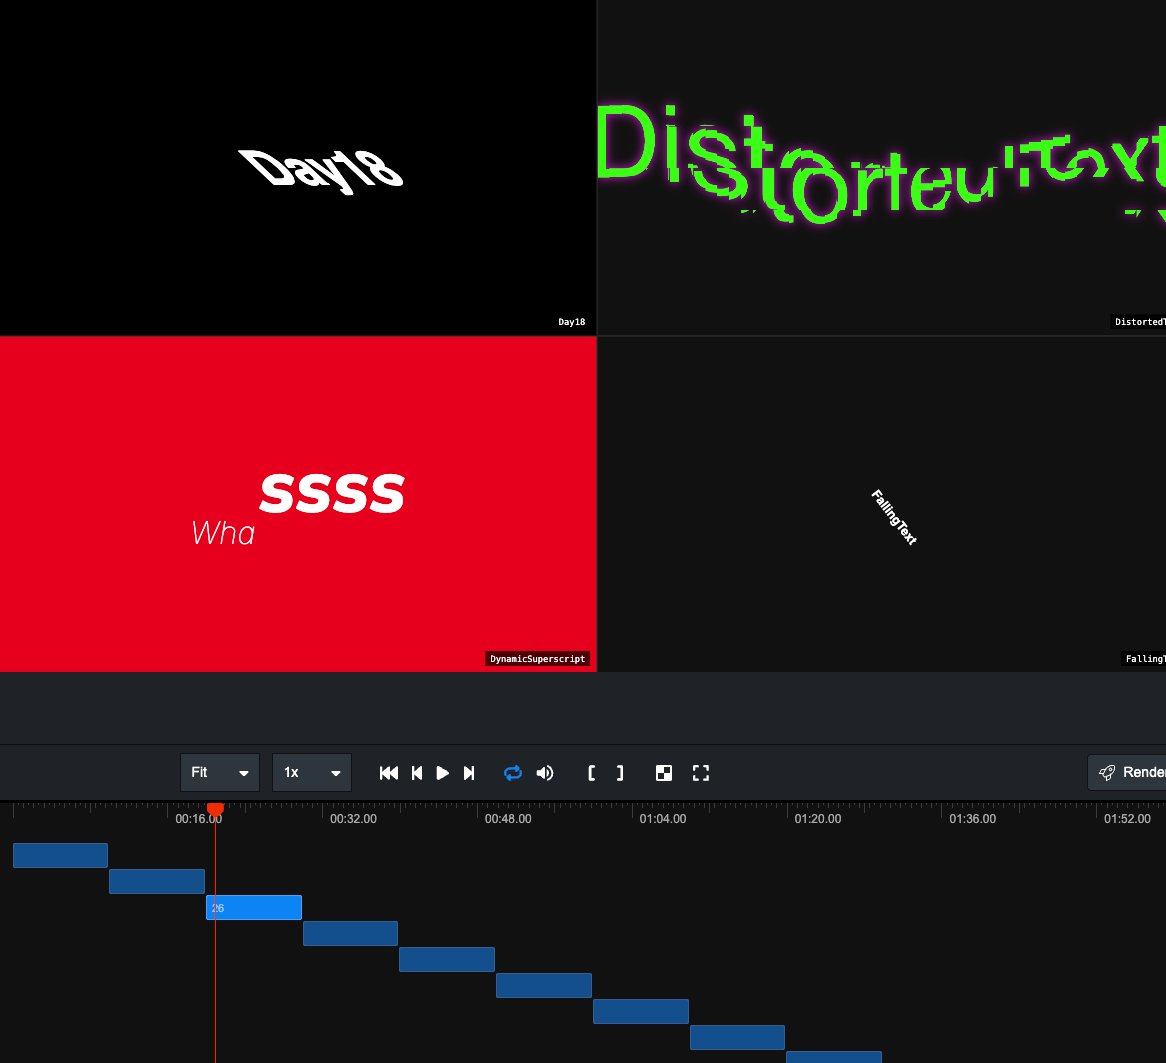
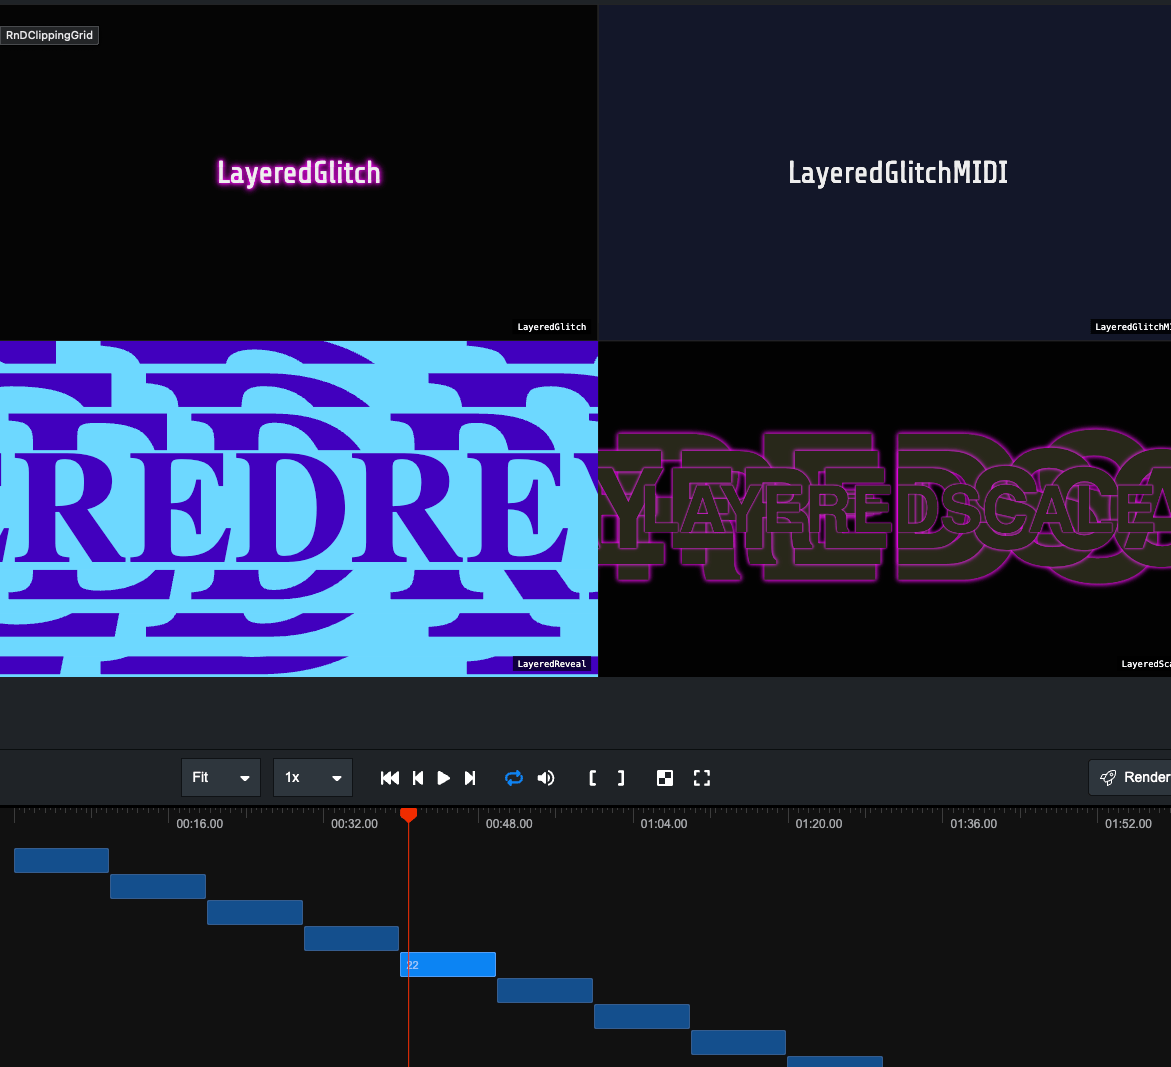
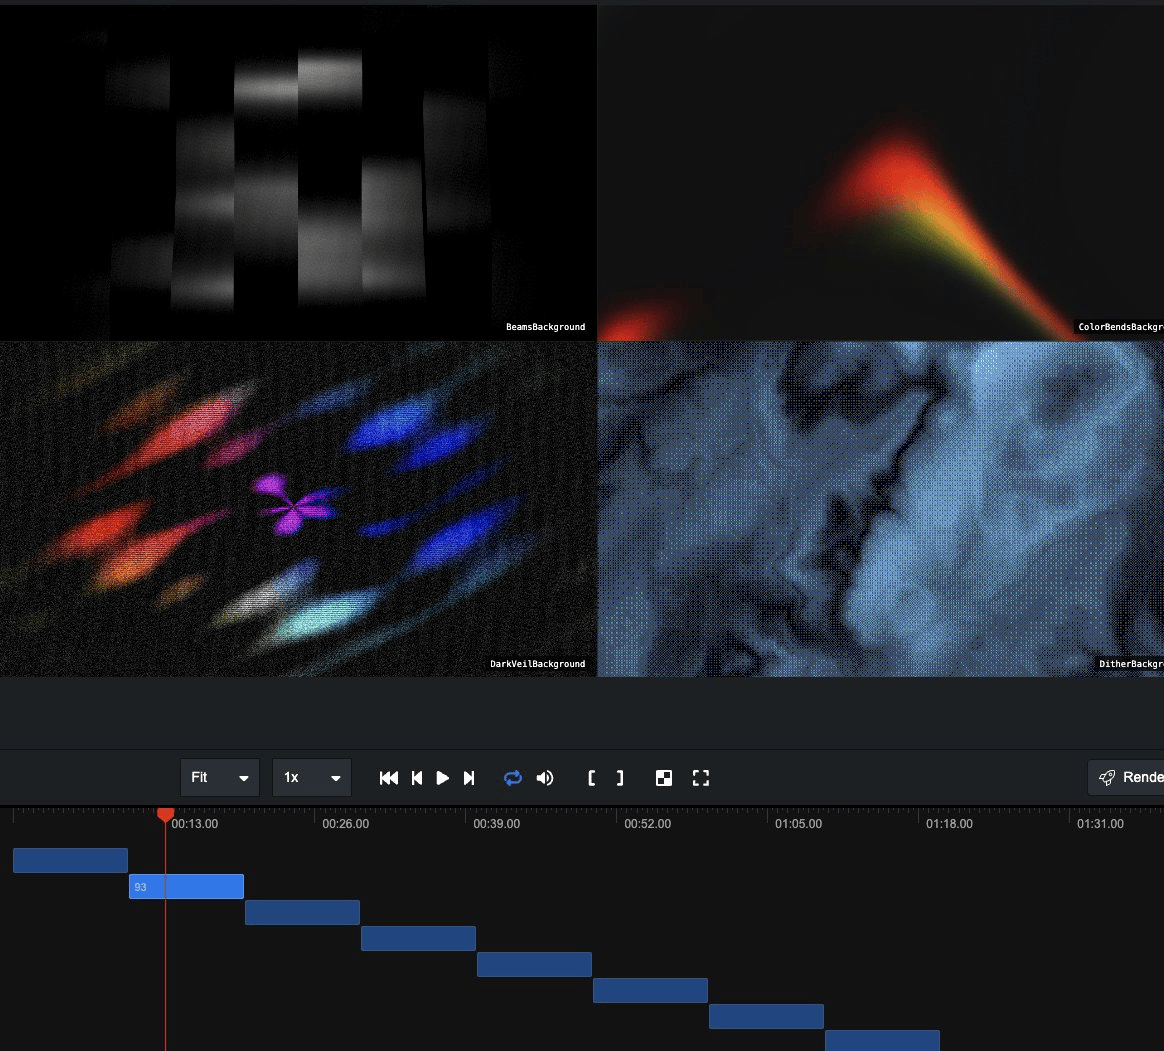
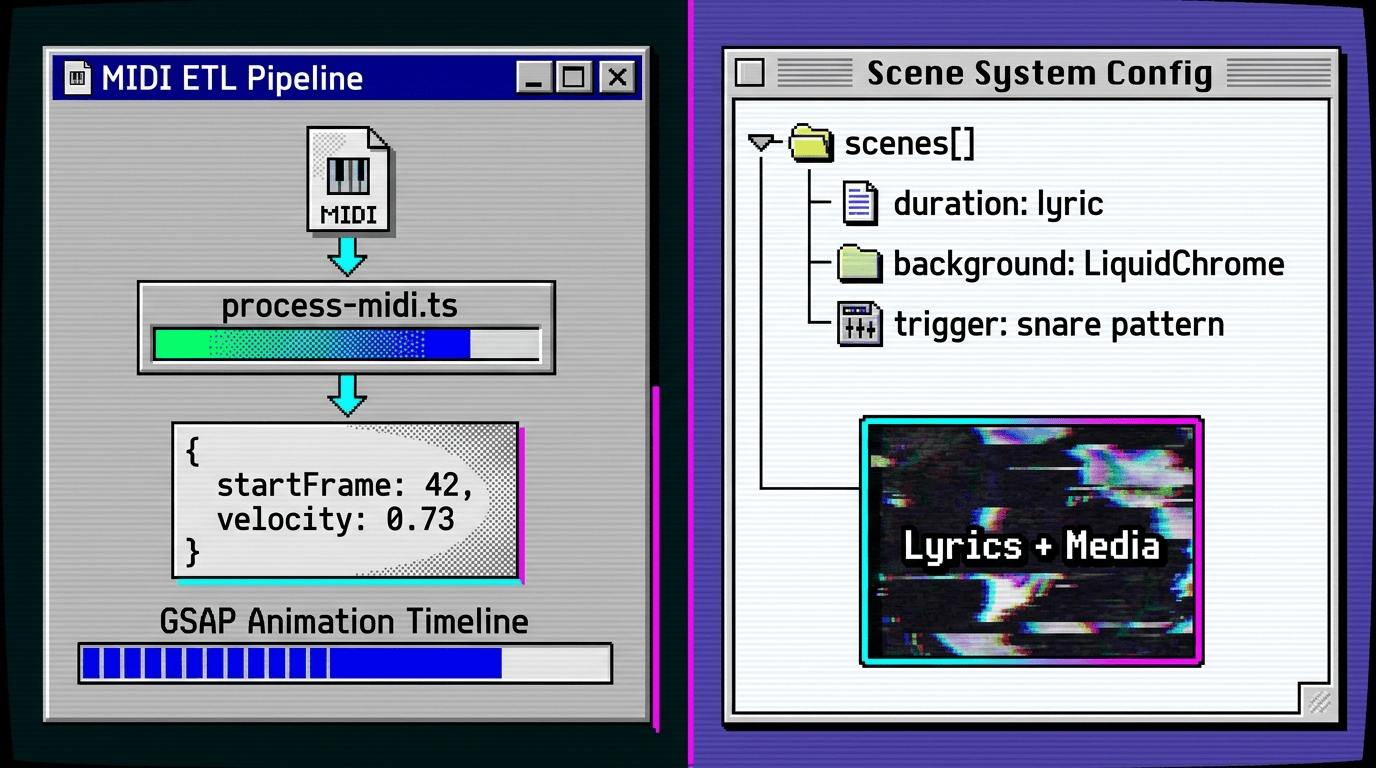
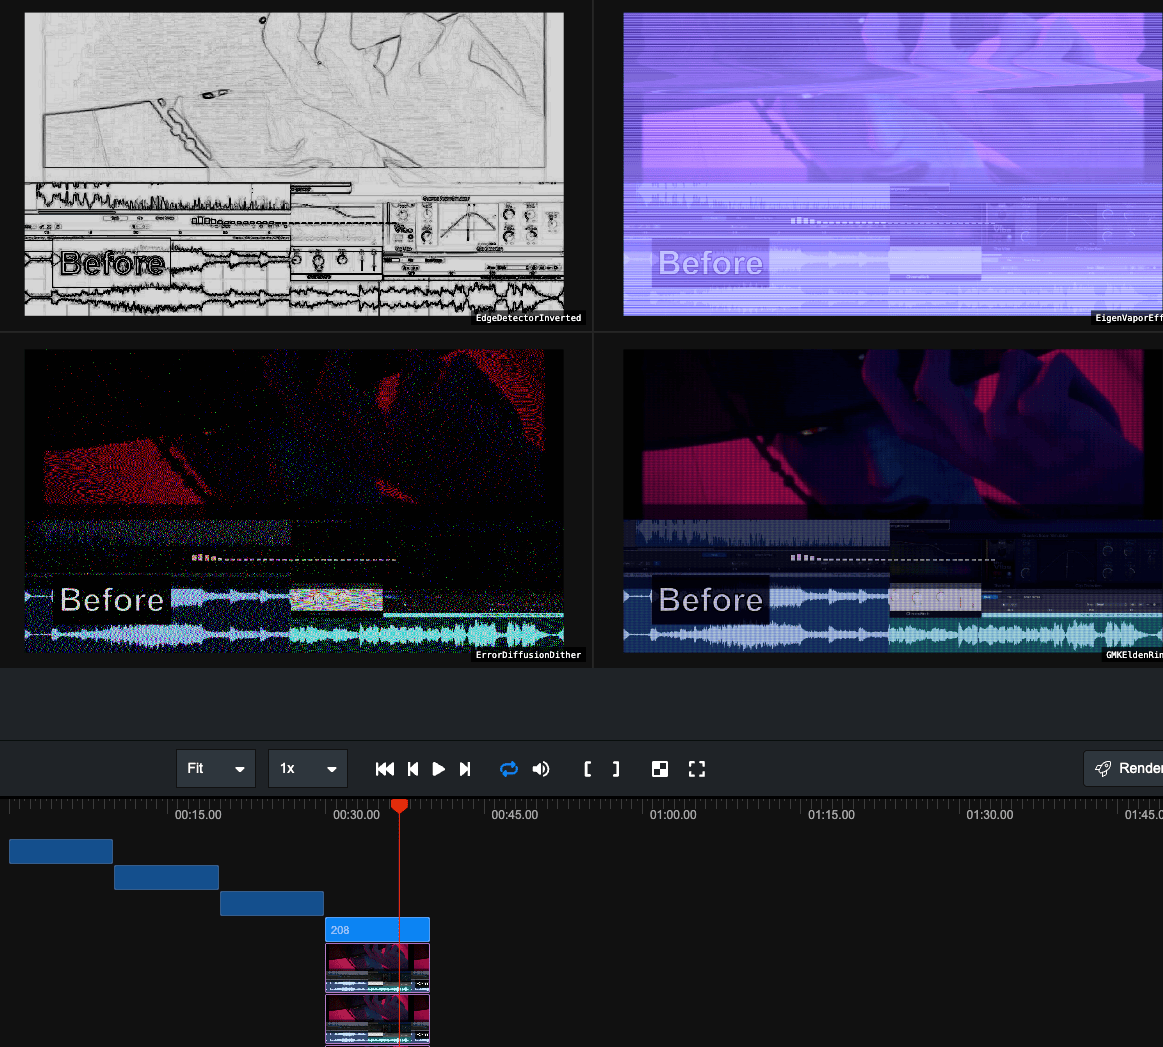
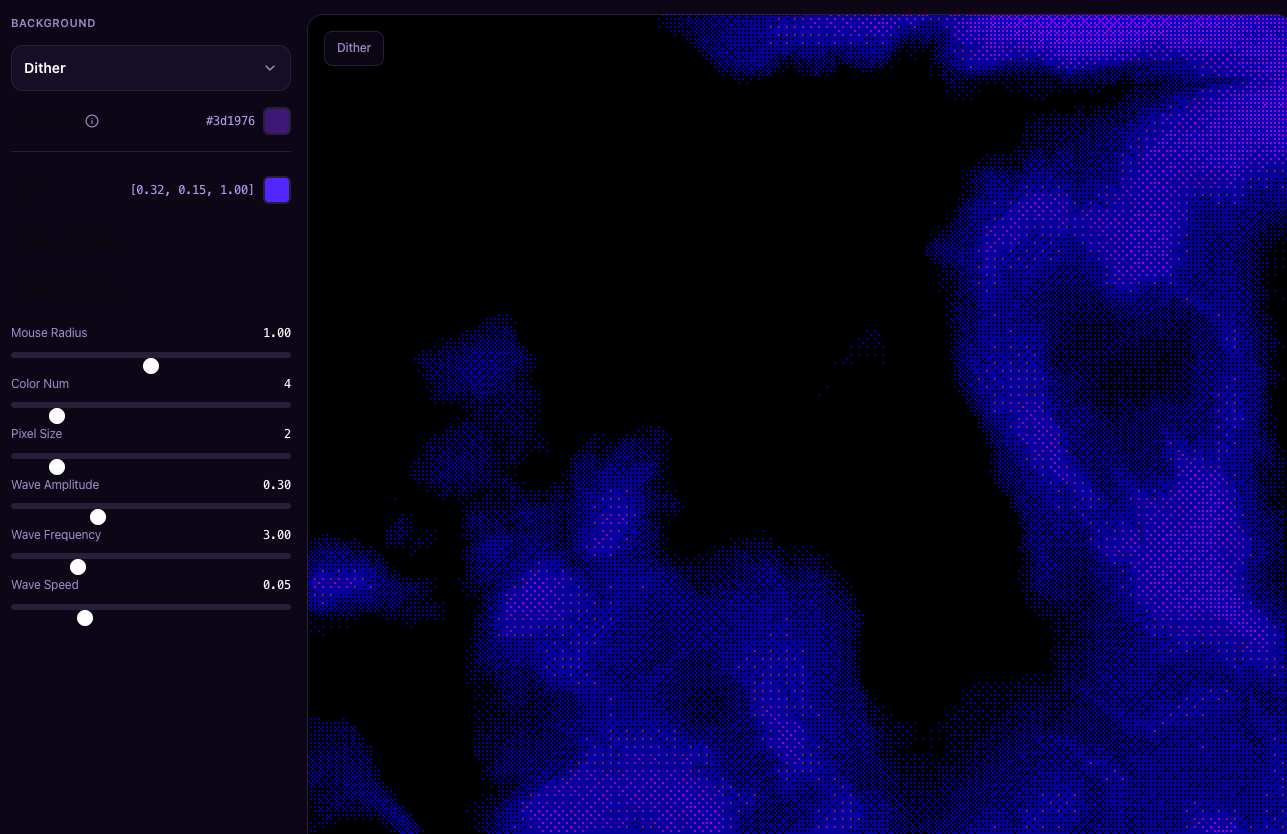
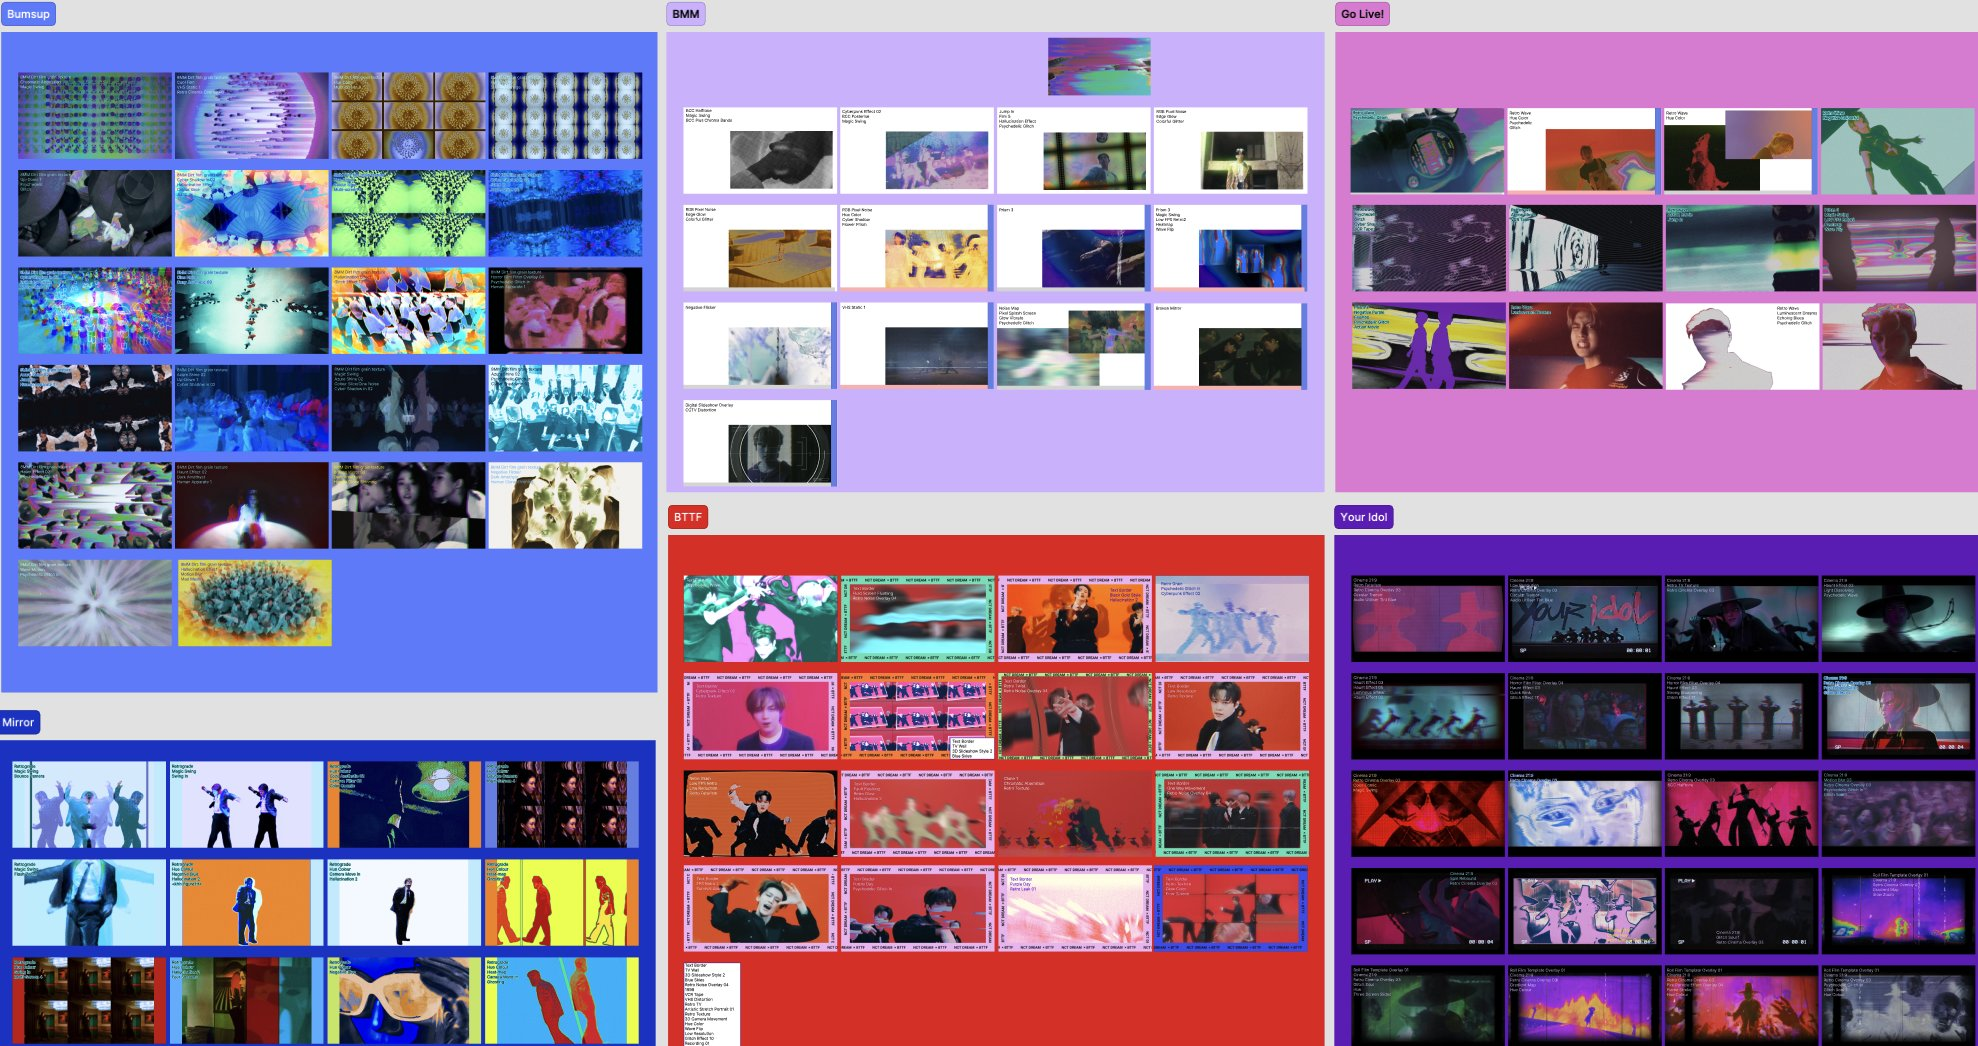
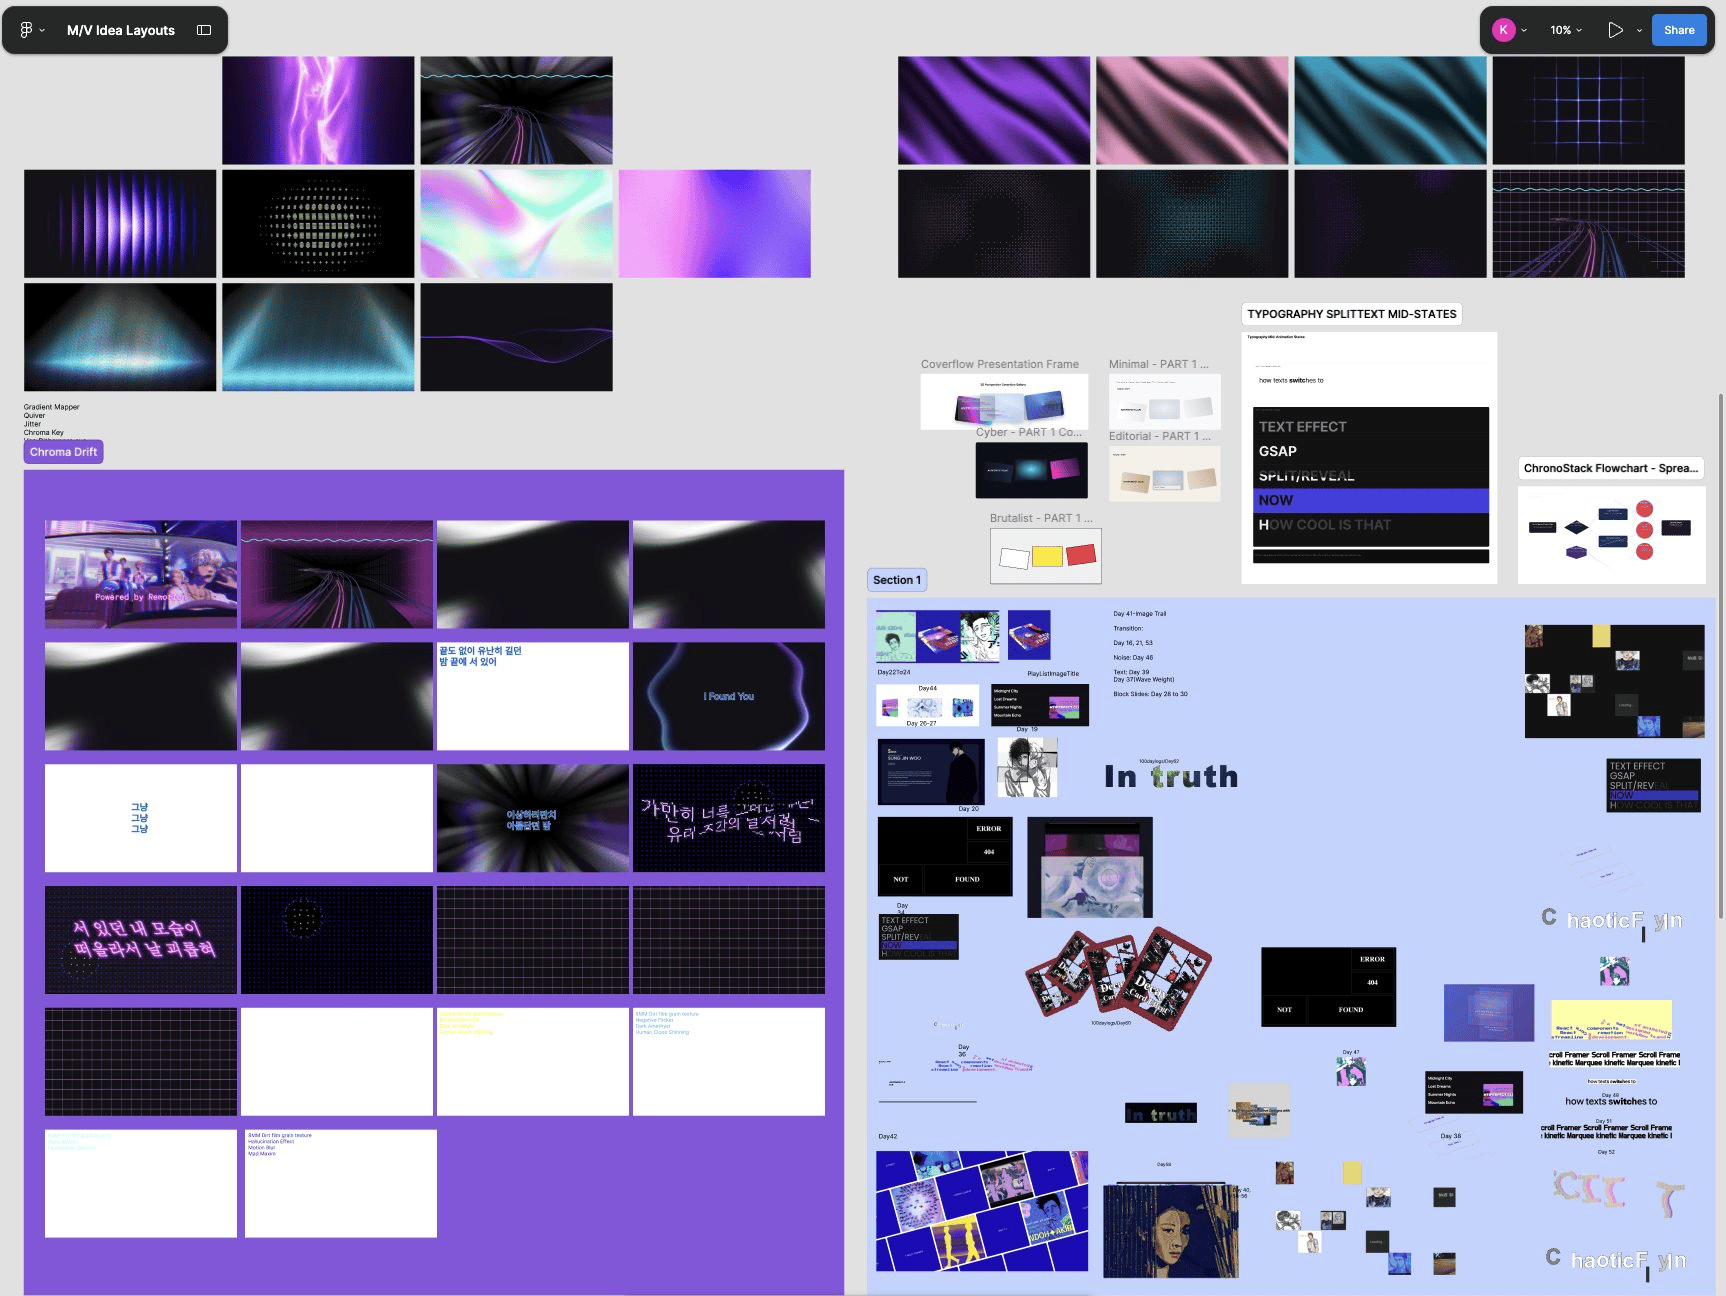
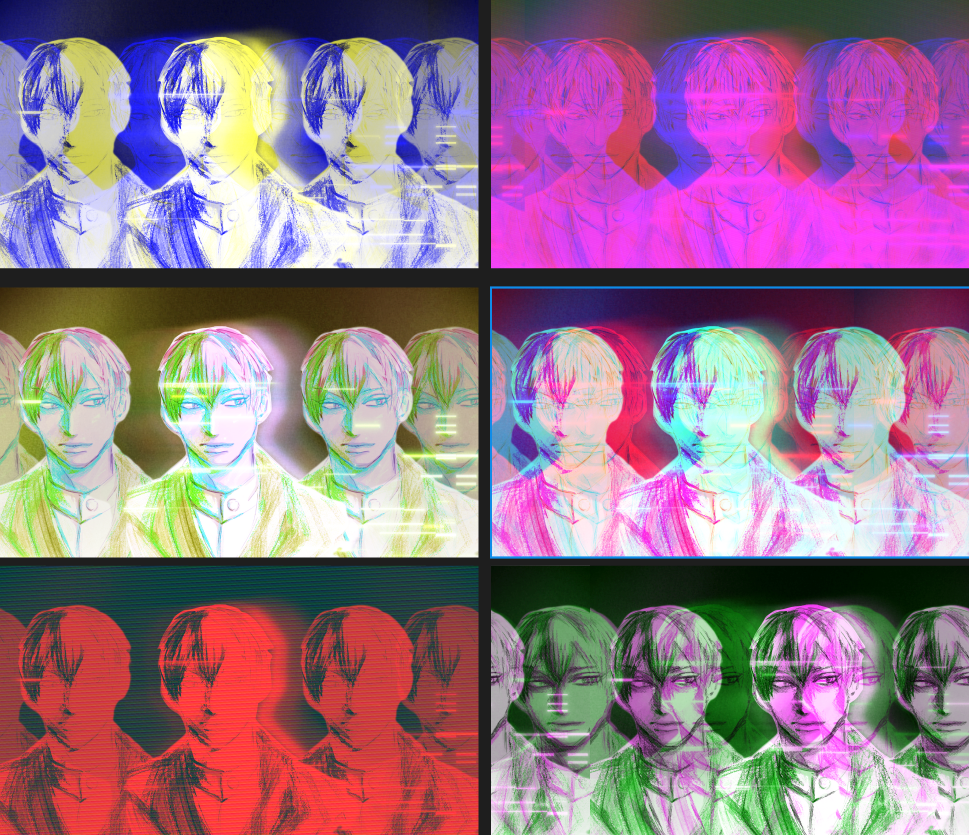
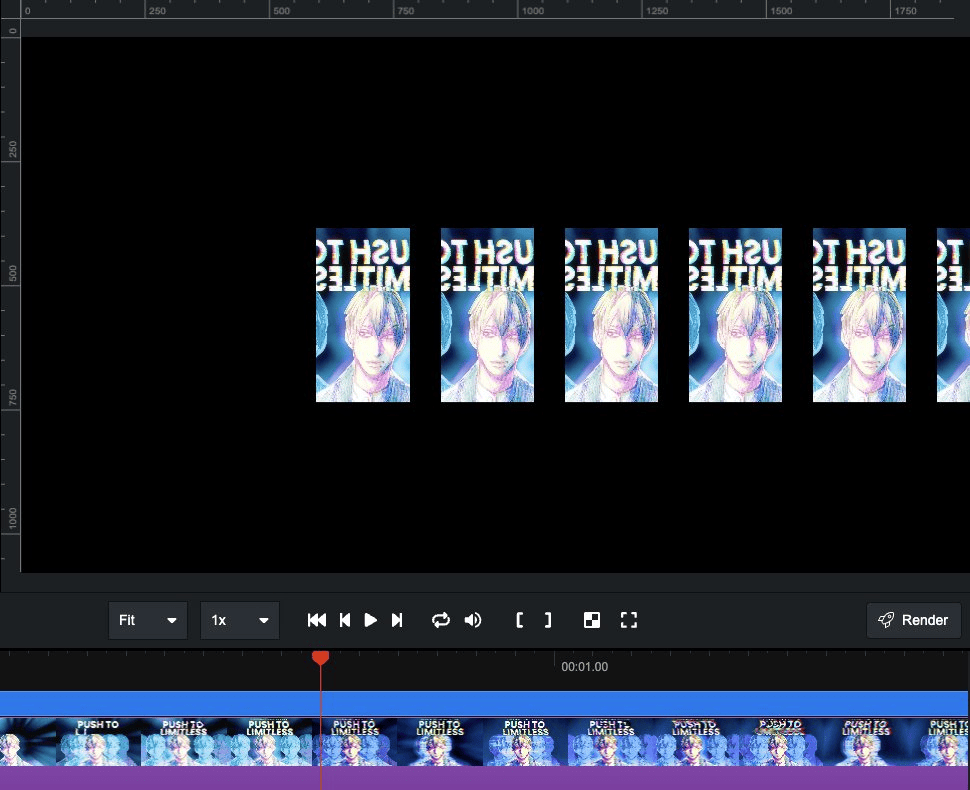
이때부터 영상의 기본 구조는 다음과 같이 정리되었다.
| 작업 영역 | 적용 방식 | 주요 기술 |
|---|---|---|
| 오디오 제작 | 보컬 녹음, 피치 보정, 믹스, 마스터링 | Logic Pro, Reaper, Melodyne, Flex Pitch, EQ, Compressor |
| 오디오 분석 | 피치 편차 및 에너지 피크 추출 | Python, ML, DSP, CSV |
| 자막 처리 | 보컬 타임코드를 SRT로 변환 | Whisper, SRT Parser |
| 영상 구성 | 프레임 단위 컴포지션 | Remotion, React, TypeScript |
| 모션 구현 | 키네틱 타이포그래피, 블록 패턴, Stagger |
useCurrentFrame(), interpolate(), CSS Variables |
| 그래픽 효과 | 노이즈, 디더링, 글리치, 텍스처 믹스 | WebGL, GLSL, Three.js, React Three Fiber |
| 사전 설계 | 레이아웃, 스토리보드, 모션 토큰 | Figma, Wireframe, Moodboard |
| 최종 디렉팅 | 음악-서사-비주얼의 통합 | 1인 디렉팅 |
2. Chroma Drift: 두 번째 버전과 오디오의 벽
첫 번째 작업이 끝난 뒤에는 Chroma Drift를 다시 바라보게 되었다. 이번에는 단순한 인스트루먼트 리워크가 아니라 직접 보컬을 녹음하고, 원곡의 MR과 내 목소리를 실제 커버곡으로 섞어보려 했다.
1월 말에 만든 첫 번째 리릭스 비주얼라이저는 원곡 리믹스에 가까웠다. 하지만 두 번째 버전에서는 보컬 녹음과 믹스마스터링이라는 더 큰 벽을 넘어야 했다.
처음에는 저가형 다이내믹 마이크를 M-Audio 오디오 인터페이스에 연결했다. 노이즈는 잡혔지만 다이내믹 레인지가 부족했고, 보컬의 강약과 질감이 제대로 살아나지 않았다. 이후 Fifine 마이크로 장비를 바꾸면서 룸 어쿠스틱과 녹음 포지션까지 다시 조정했다.
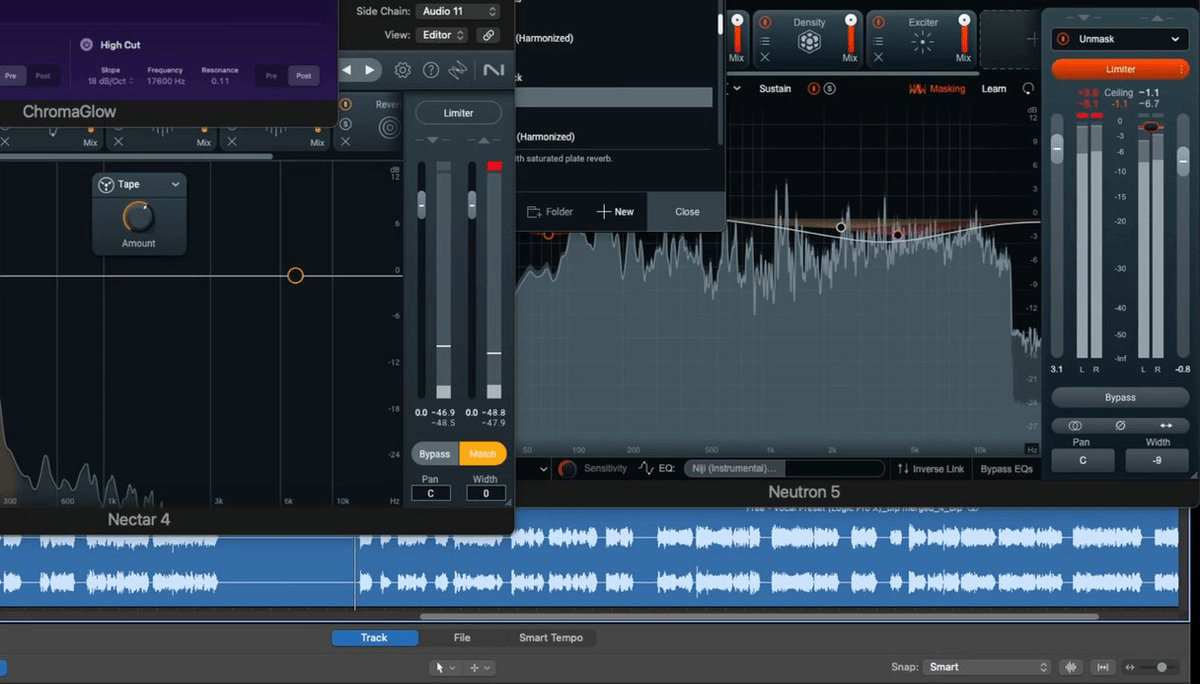
보컬 믹스와 악기 트랙의 피치를 대조하고 마스킹을 조정하는 과정은 생각보다 훨씬 까다로웠다. 원곡은 이미 해당 가수의 음색에 맞춰 EQ와 공간감이 설계되어 있었기 때문이다. 그냥 MR 위에 내 목소리를 얹는다고 끝나는 일이 아니었다.
여기서 데이터 분석 전공과 ML 경험을 활용했다. Python으로 가이드 보컬과 내 보컬의 피치 편차를 추출하고, RVC 모델에 내 목소리 데이터를 학습시켜 피치 차이를 분석했다. 다만 최종 음원에 RVC 생성물을 그대로 사용하지는 않았다. 감정과 드라마가 들어간 사람의 목소리를 생성 모델이 완벽하게 보존하지 못했고, 내 환경에서는 기계적인 노이즈가 남았다.
결국 Logic Pro를 열고 Melodyne과 Flex Pitch로 직접 보정하는 편이 훨씬 빨랐다. (2026년 AI 시대에 결국 손으로 음정을 깎고 있는 인간의 모습이다.)
관련 작업은 KR-the-journey-of-audio-vocalign-analysis와 KR-the-journey-of-audio-recording-mix-audio-composition에 정리해두었다.
3. Remotion 기반 영상 아키텍처
전통적인 NLE만으로는 수백 개의 가사 텍스트와 반응형 비주얼을 프레임 단위로 제어하기 어려웠다. 그래서 React 기반의 Remotion과 TypeScript를 중심으로 영상 아키텍처를 구성했다.
Remotion은 Whisper가 추출한 보컬 타임코드와 SRT 데이터를 읽어들인다. 각 자막 구간은 다시 텍스트 컴포넌트와 애니메이션 파라미터로 분해된다.
가사 한 줄은 단순 문자열이 아니다.
- 시작 프레임
- 종료 프레임
- 글자별 등장 시간
- 자간 변화
- 가로·세로 레이아웃
- Stagger 방향
- 컬러와 블렌딩 모드
- 음성 신호와의 반응 타이밍
이 값들이 하나의 데이터 구조가 되어야 한다.
초기 코드에는 GSAP 기반 로직과 Remotion native 로직이 한 파일 안에 뒤섞여 있었다. requestAnimationFrame 중심의 GSAP과 프레임 렌더링 중심의 Remotion은 타이밍 모델부터 달랐다.
문제는 대략 이랬다.
-
MotionReveal.tsx,MotionStagger.tsx,TypoStagger.tsx가 모두 children 순차 등장을 담당 -
staggerOrderToGsap과resolveStaggerIndex가 같은 StaggerOrder를 이중 해석 -
MOTION_MAP은 별도 책임을 가지고도 분리되지 않음 - 38KB에 달하는
motionVariants.ts가 모든 역할을 떠안음
전면 교체 대신 레이어 분리 전략을 선택했다. 기존 GSAP 계열은 유지하고, _motion/ 아래에 Remotion-native 레이어를 추가했다. 이게 내가 택한 아키텍처다. (한 번에 갈아엎었다가 같이 폭사하는 것보다는 낫다.)
5월 작업은 다음과 같이 진행되었다.
| 날짜 | 프로젝트 / 작업 | 내용 |
|---|---|---|
| 5/14 |
_shared 리팩토링 |
motionVariants.ts 과부하와 GSAP·Remotion 충돌 분석 |
| 5/23 | Chroma Drift | 보컬 커버와 타이포 프로그레스 시작 |
| 5/27 | Chroma Drift / Niji | 첫 번째 씬 완성 후 Niji 착수 |
| 5/28 | 대규모 클린업 | Jitter 제거, 루트 정리, VideoStagger 분리 |
| 5/29 | ChaoticFlyIn | 실패 후 수정, 범용화, 수직 모드 추가 |
| 5/29–30 | Lyrics MV 베이스 | 가사 적용과 설정 구조 완성 |
4. WebGL과 자체 프로덕션 툴
웹 브라우저에서 정상적으로 보이는 WebGL 컴포넌트가 Remotion 렌더링에서는 검은 화면으로 나오거나, 일부 버텍스가 사라지는 경우가 있었다.
Three.js의 기본 프레임은 60fps이고, Remotion은 프로젝트 기준 30fps였다. 브라우저의 실시간 렌더링과 비디오 프레임 추출 과정의 라이프사이클도 달랐다.
그래서 Shadertoy와 React Bits에서 영감을 받은 셰이더를 그대로 가져오는 대신, GLSL의 vertex와 fragment 구조를 분해해 Remotion에 맞는 자체 컴포넌트로 다시 만들었다.
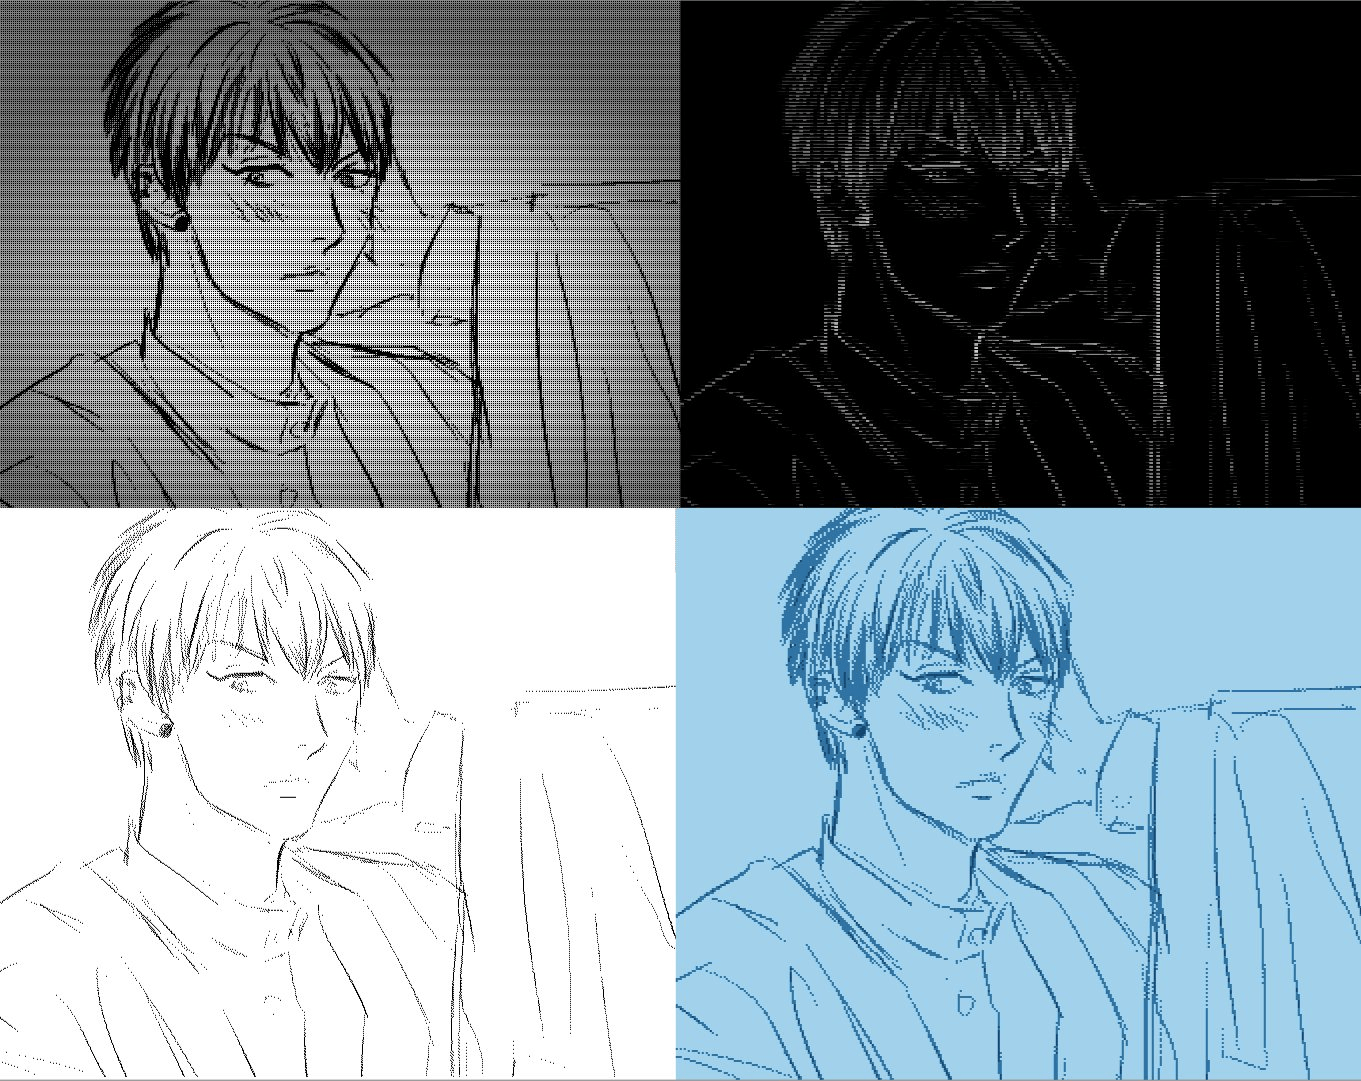
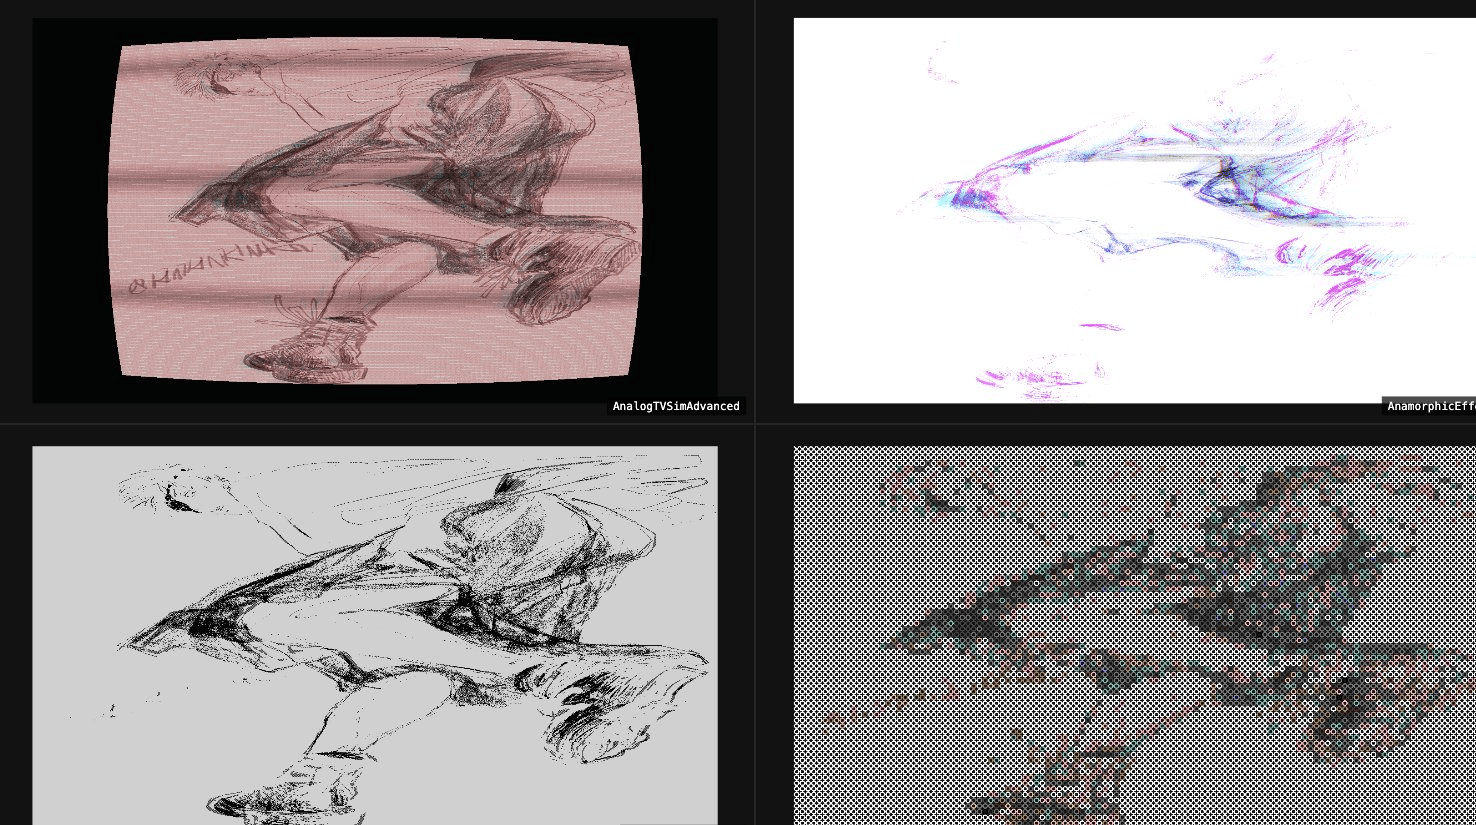
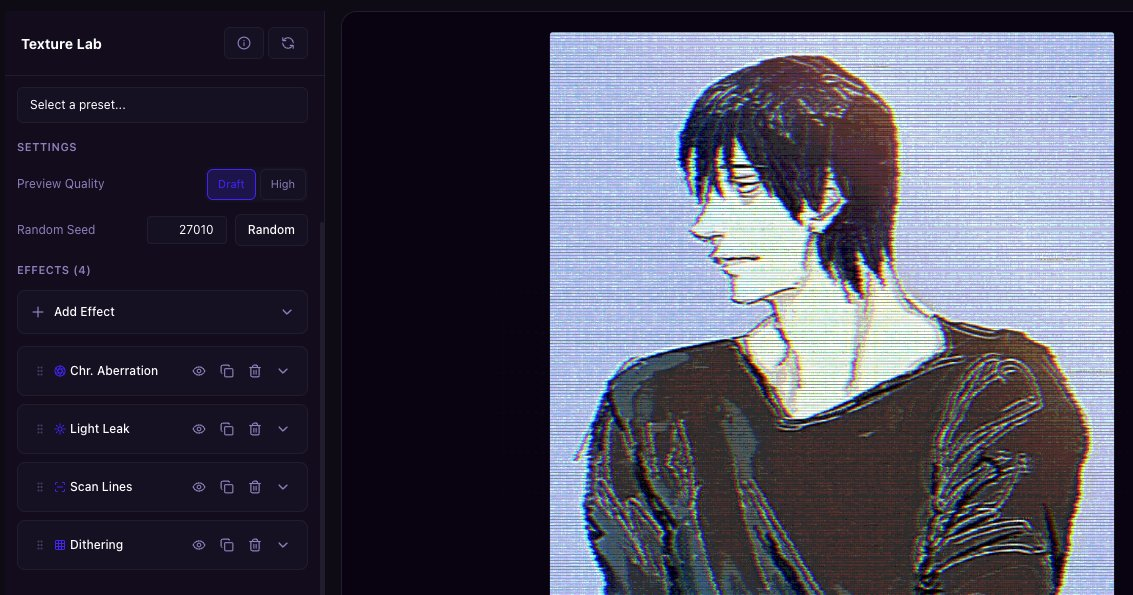
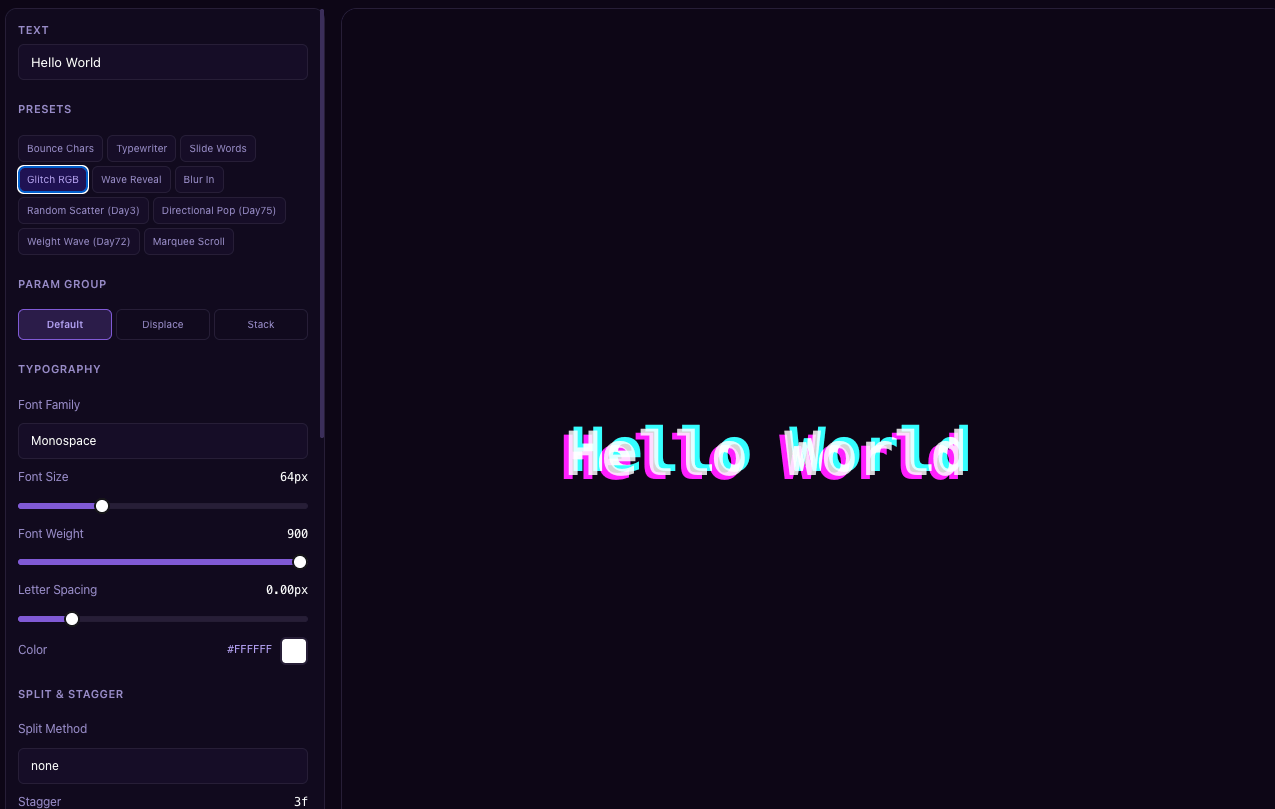
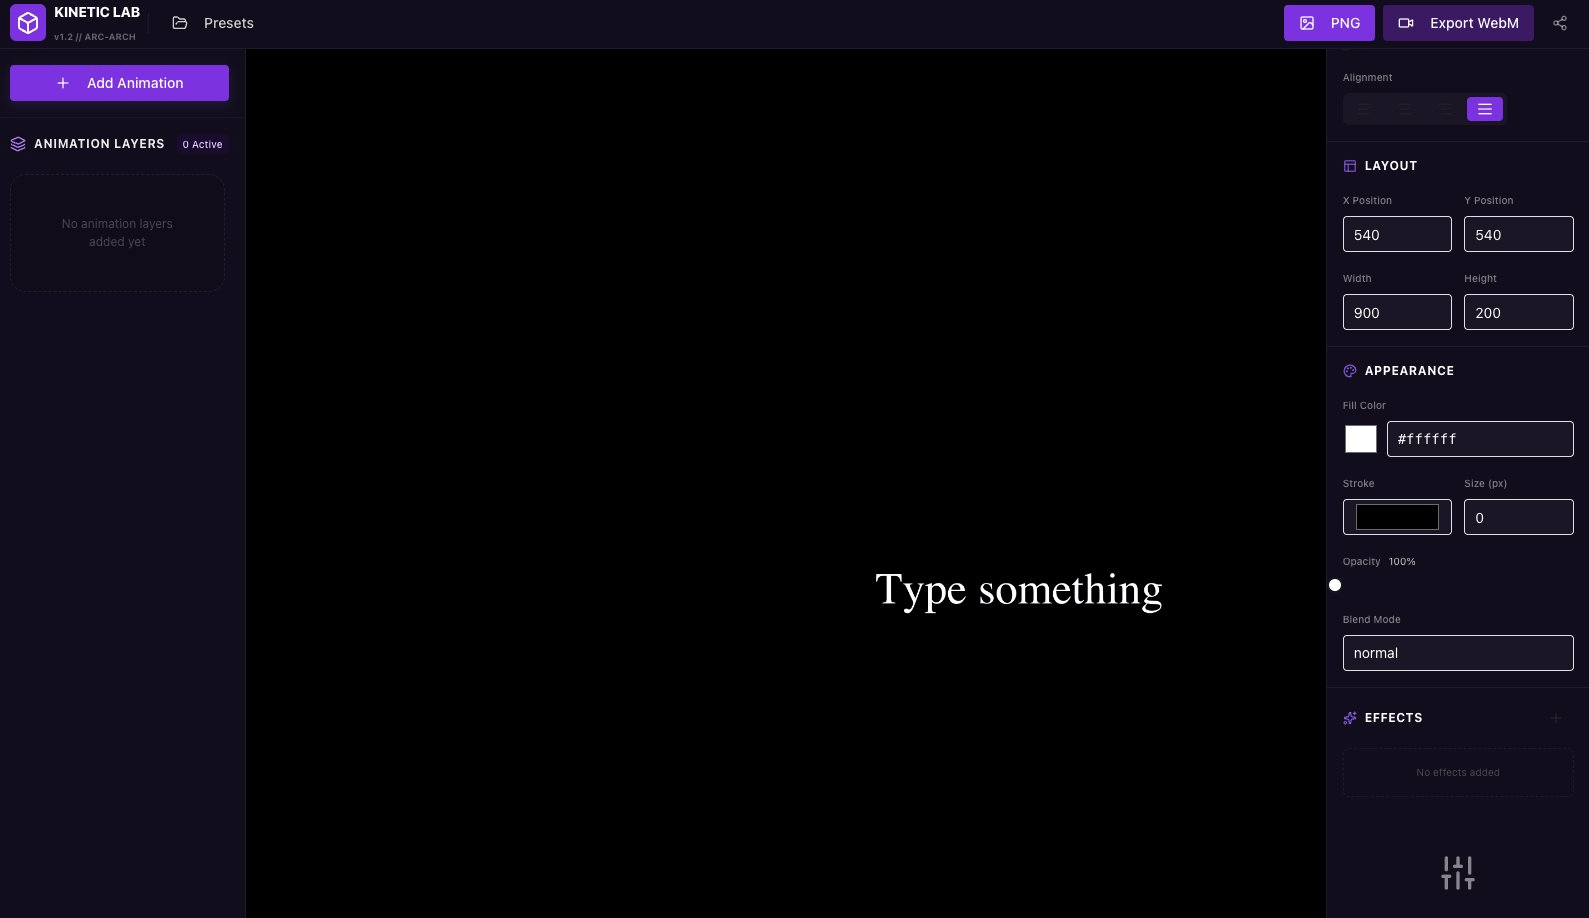
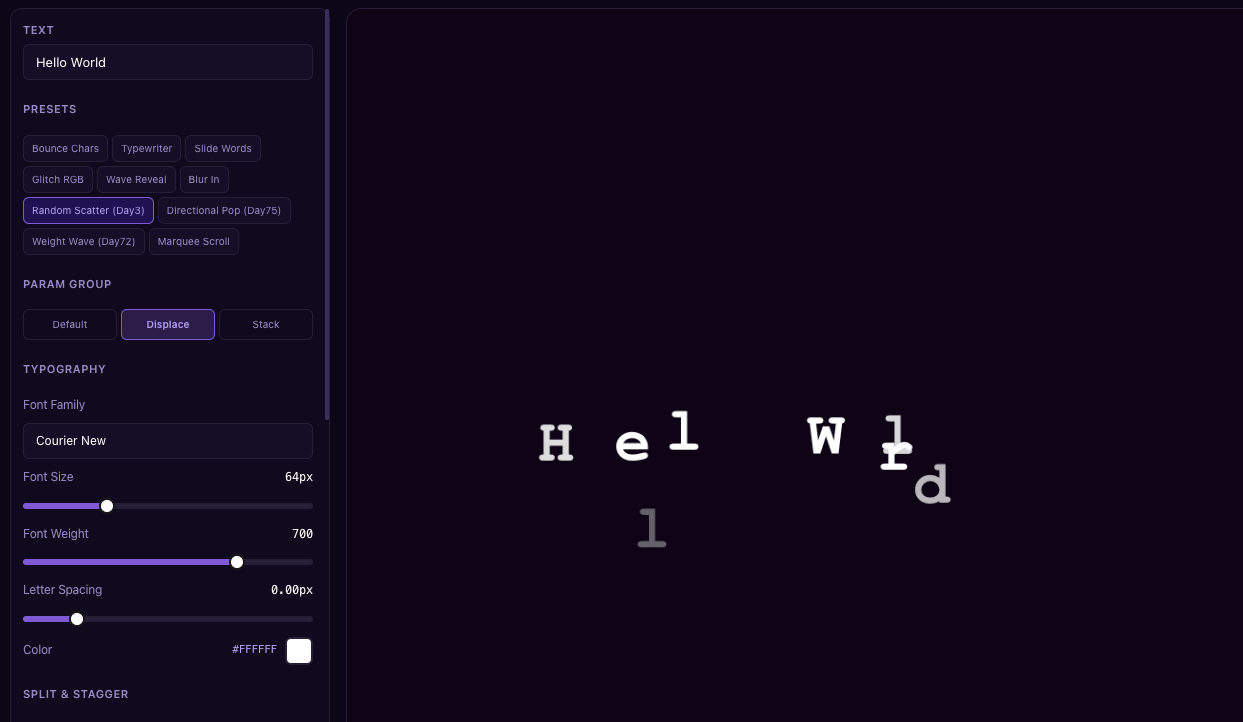
내가 만든 Background Maker는 GUI에서 셰이더 파라미터를 조정하고, 마음에 드는 설정을 schema로 추출한 뒤 Remotion에서 다시 배열해 렌더링하는 방식이다.
Texture Mix는 이미지 위에 여러 vertex와 fragment, 노이즈, VHS 질감, 글리치 컬러를 레이어처럼 쌓는다. 최종 결과는 WebGL 텍스처이지만, 영상 안에서는 음악과 자막의 타이밍에 맞춰 프레임 단위로 제어된다.
이 자체 툴들은 범용 SaaS가 아니다. 사용자가 나 하나뿐인 이상한 제작환경용 도구다. (시장 수요가 없는 것을 굳이 제품이라고 우기며 오픈할 필요는 없었다.)
5. Figma에서 모션 시스템으로
코드부터 켜면 바로 지옥으로 들어간다. 그래서 먼저 Figma에서 이미지, 텍스트, 컬러, 모션 블록을 나열하고 전체 구조를 확인했다.
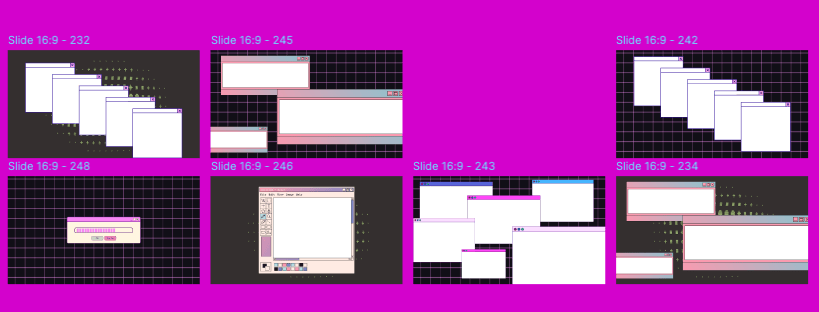
옛날 Windows 운영체제에서 시스템이 프리징될 때 창들이 시차를 두고 겹쳐 보이던 장면에서 영감을 받아 윈도우 프레임을 설계했다.
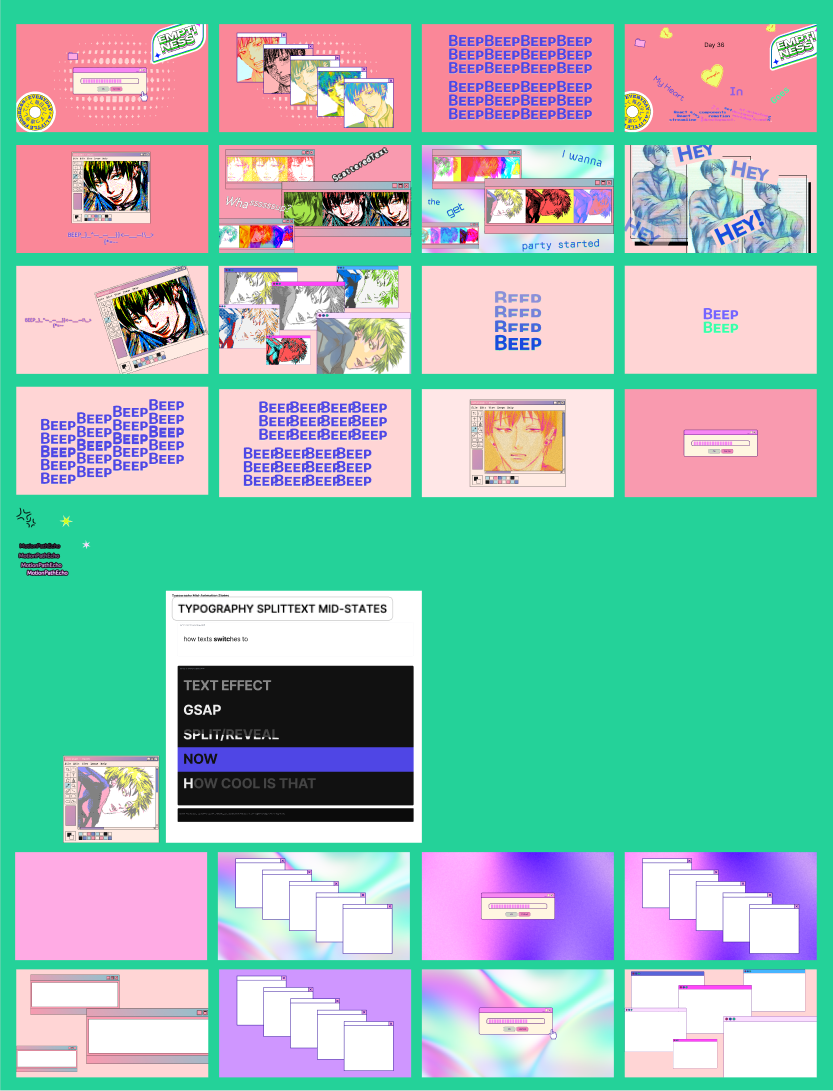
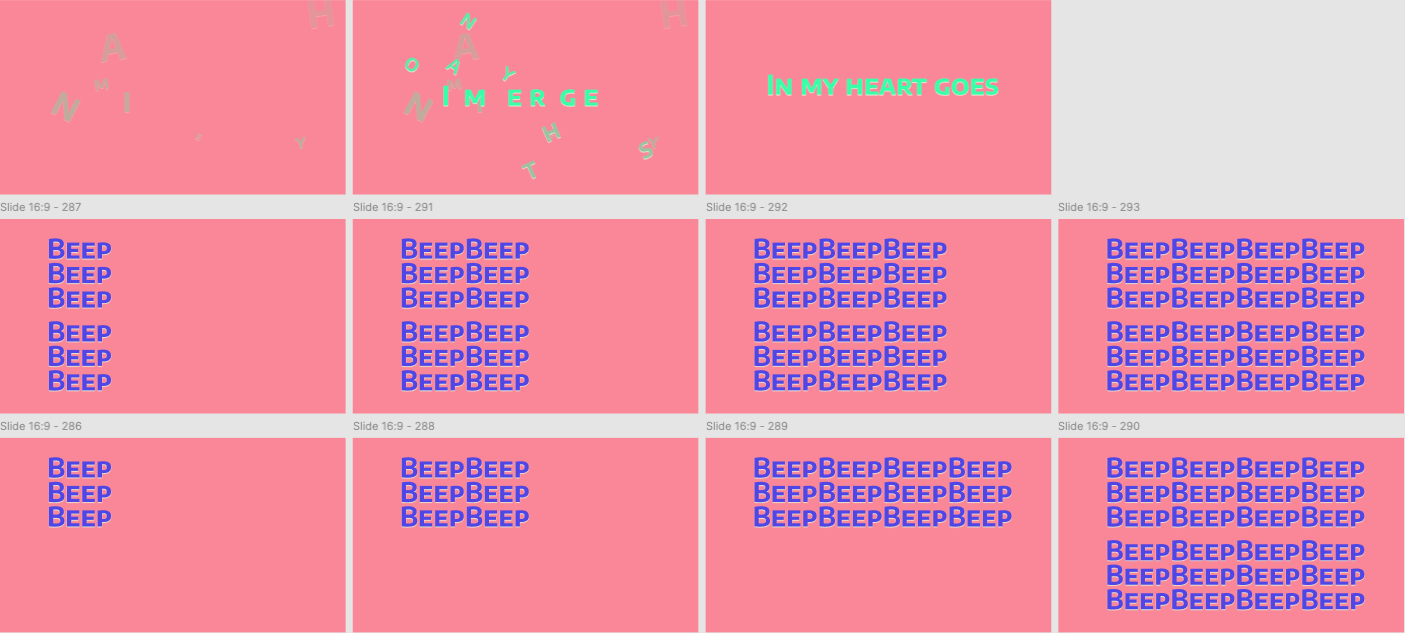
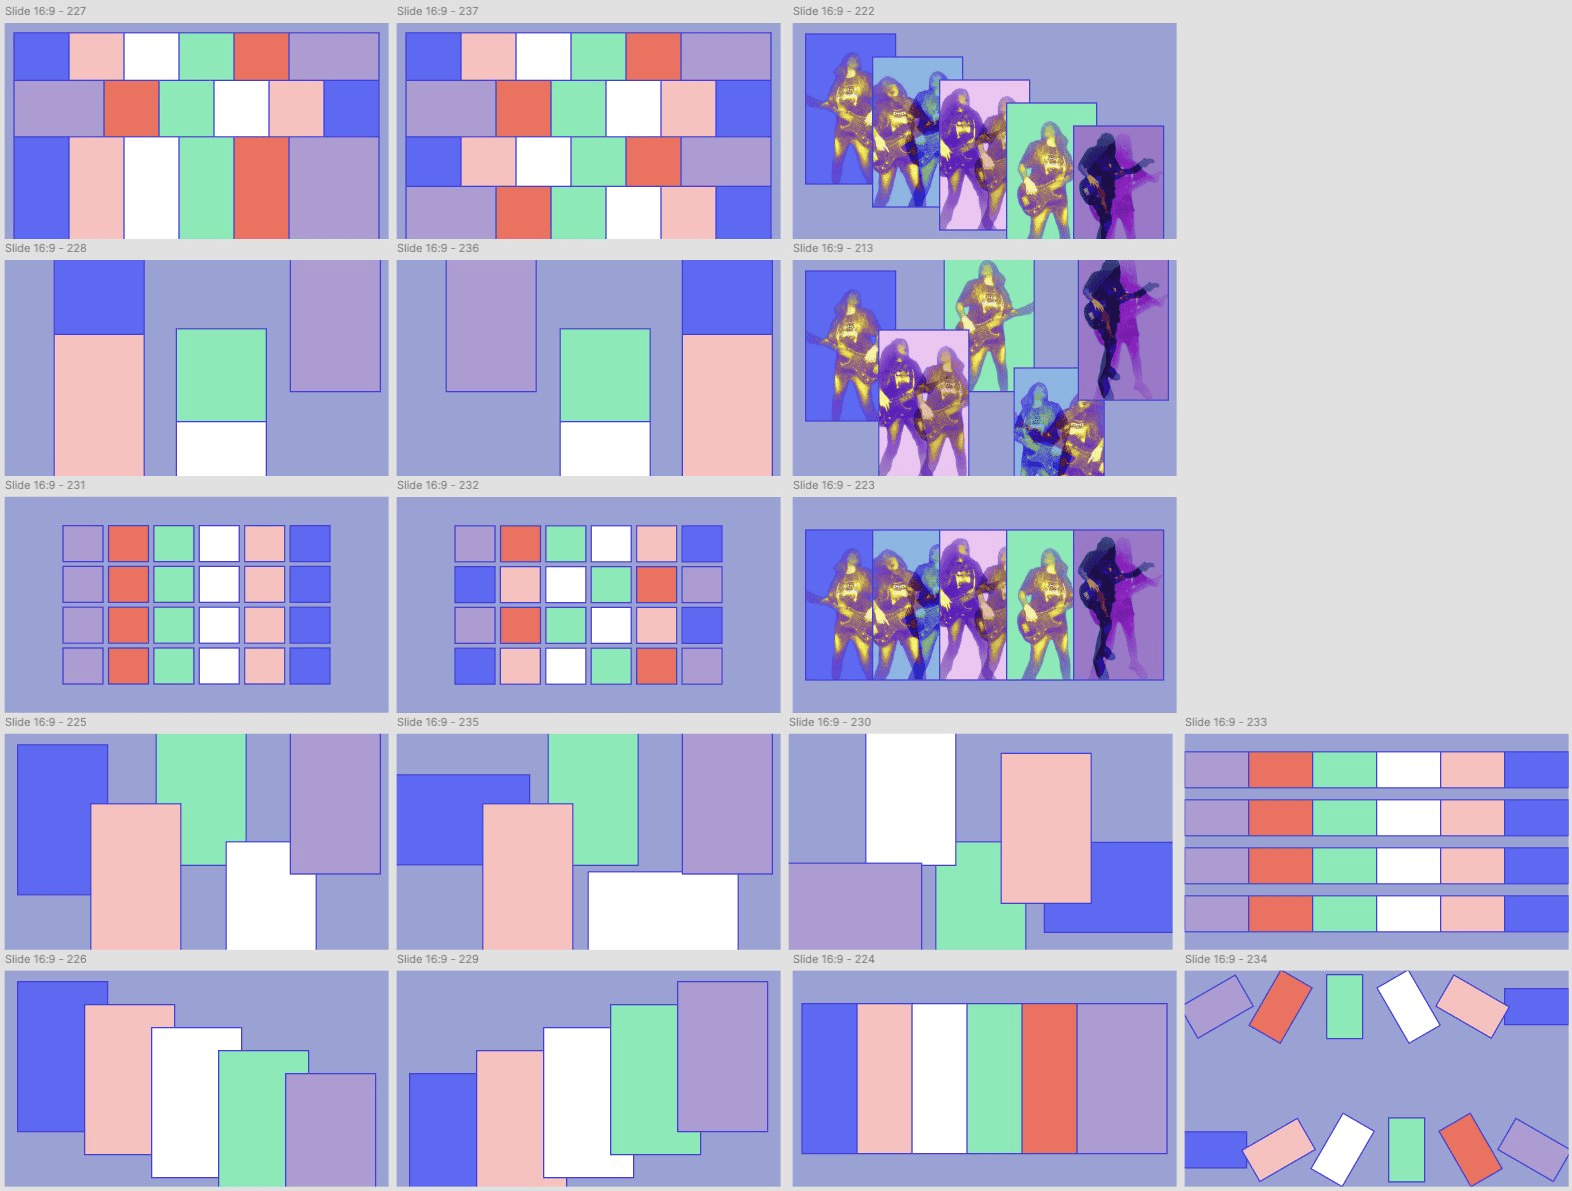
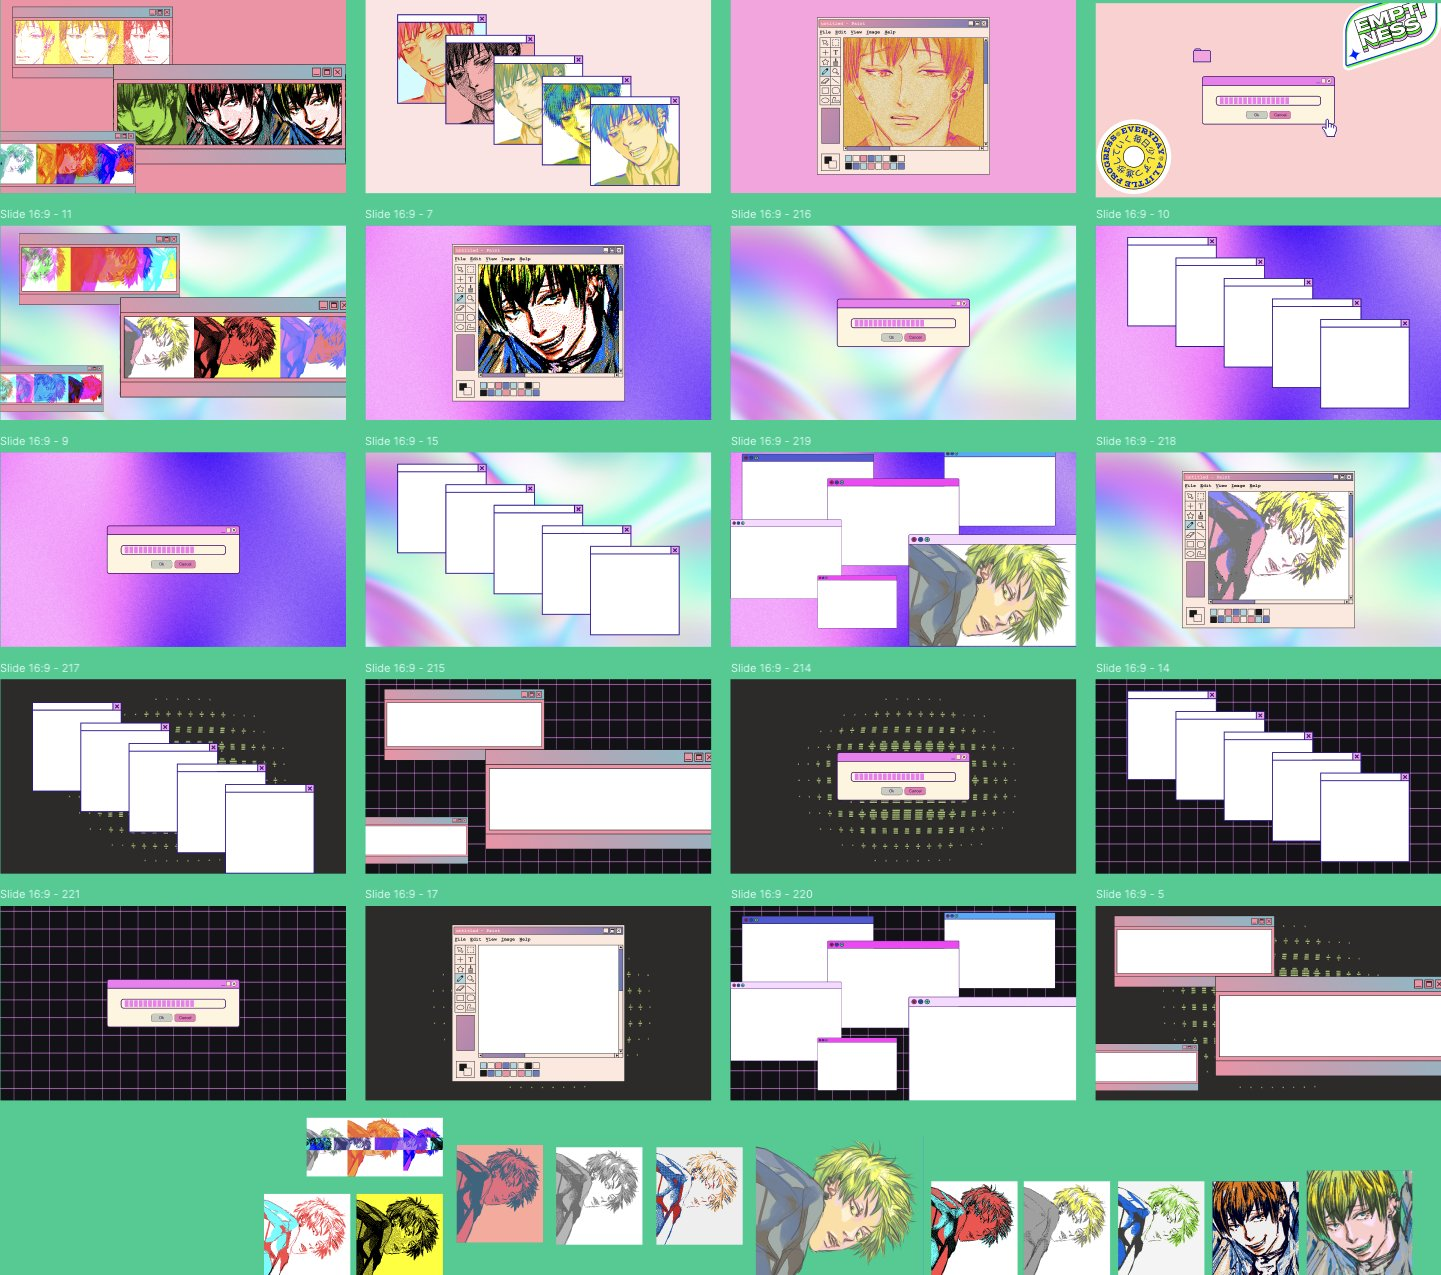
여러 모션 샘플을 컴포넌트 토큰으로 만들고, 이미지와 텍스트를 끼워 넣을 수 있는 모션 스토리보드 덱을 구성했다. 나는 이것을 Motion CX Journey System이라고 부른다.
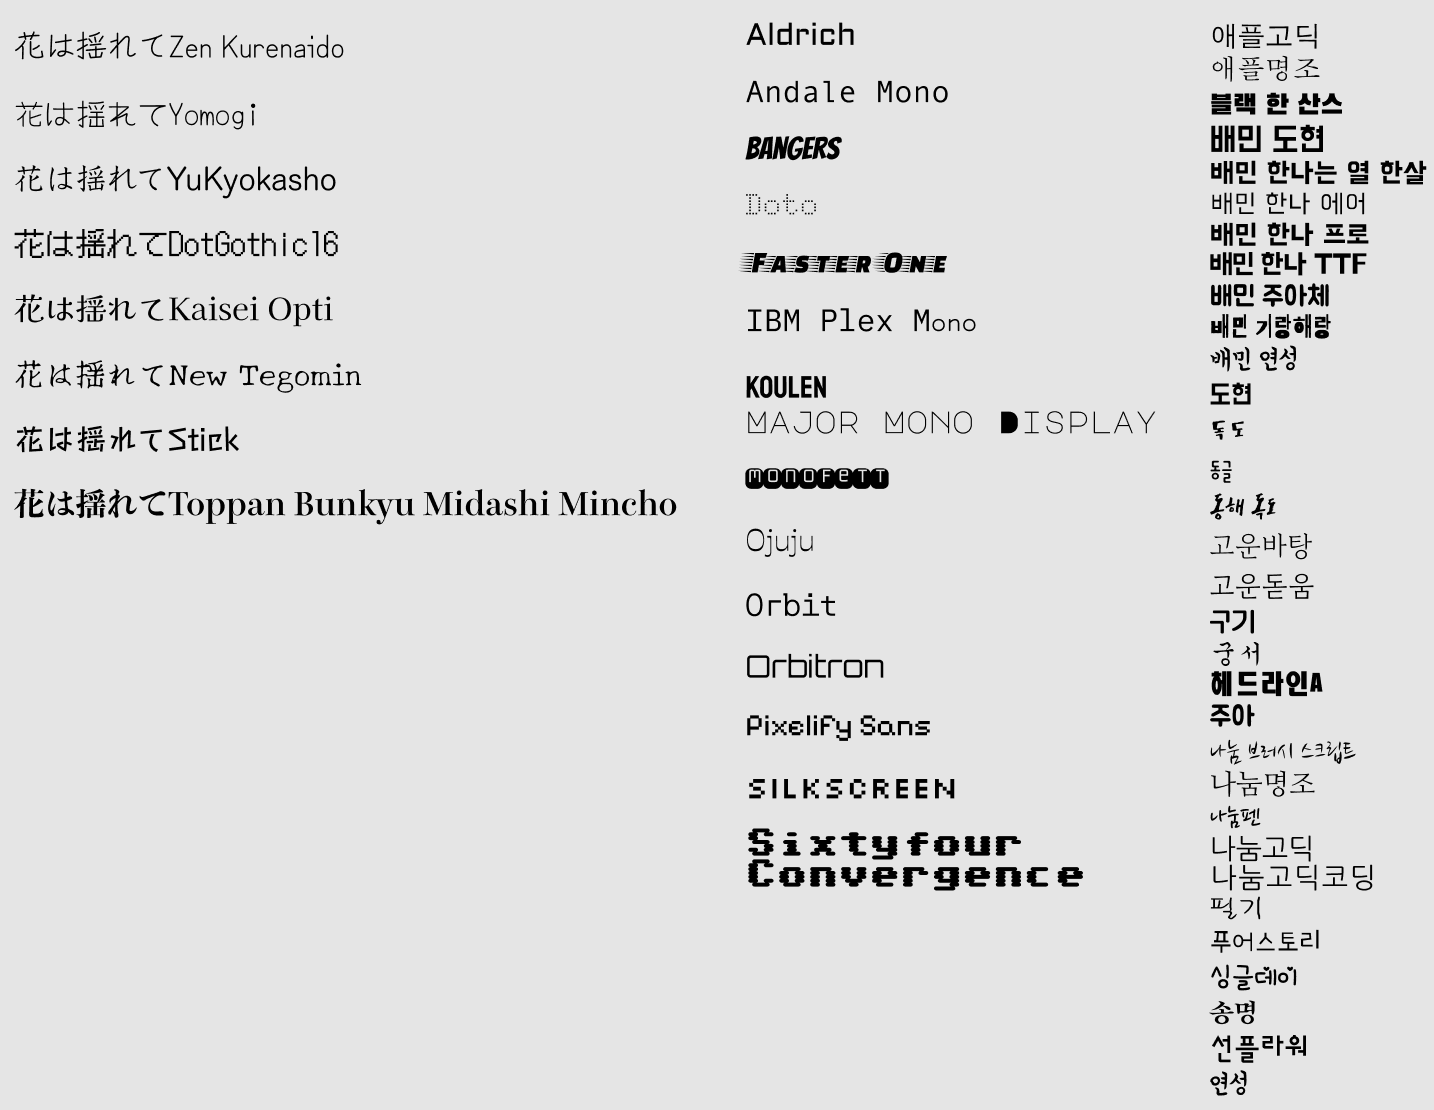
타이포그래피는 라이선스, 자간, 크기, 웹 임포트 가능 여부까지 확인해 리스트화했다. 이 과정은 일반적인 UX 디자인 시스템과 크게 다르지 않았다.
리서치 → 레퍼런스 수집 → 무드보드 → 와이어프레임 → 디자인 토큰 → 컴포넌트 카탈로그 → 프로토타이핑 → 코드 구현.
결국 모션 UX도 사용자가 관객으로 바뀌었을 뿐, 구조는 똑같았다.
6. Chroma Drift에서 만든 모션 패턴
Chroma Drift에서는 여러 레이아웃과 애니메이션 패턴을 테스트했다.
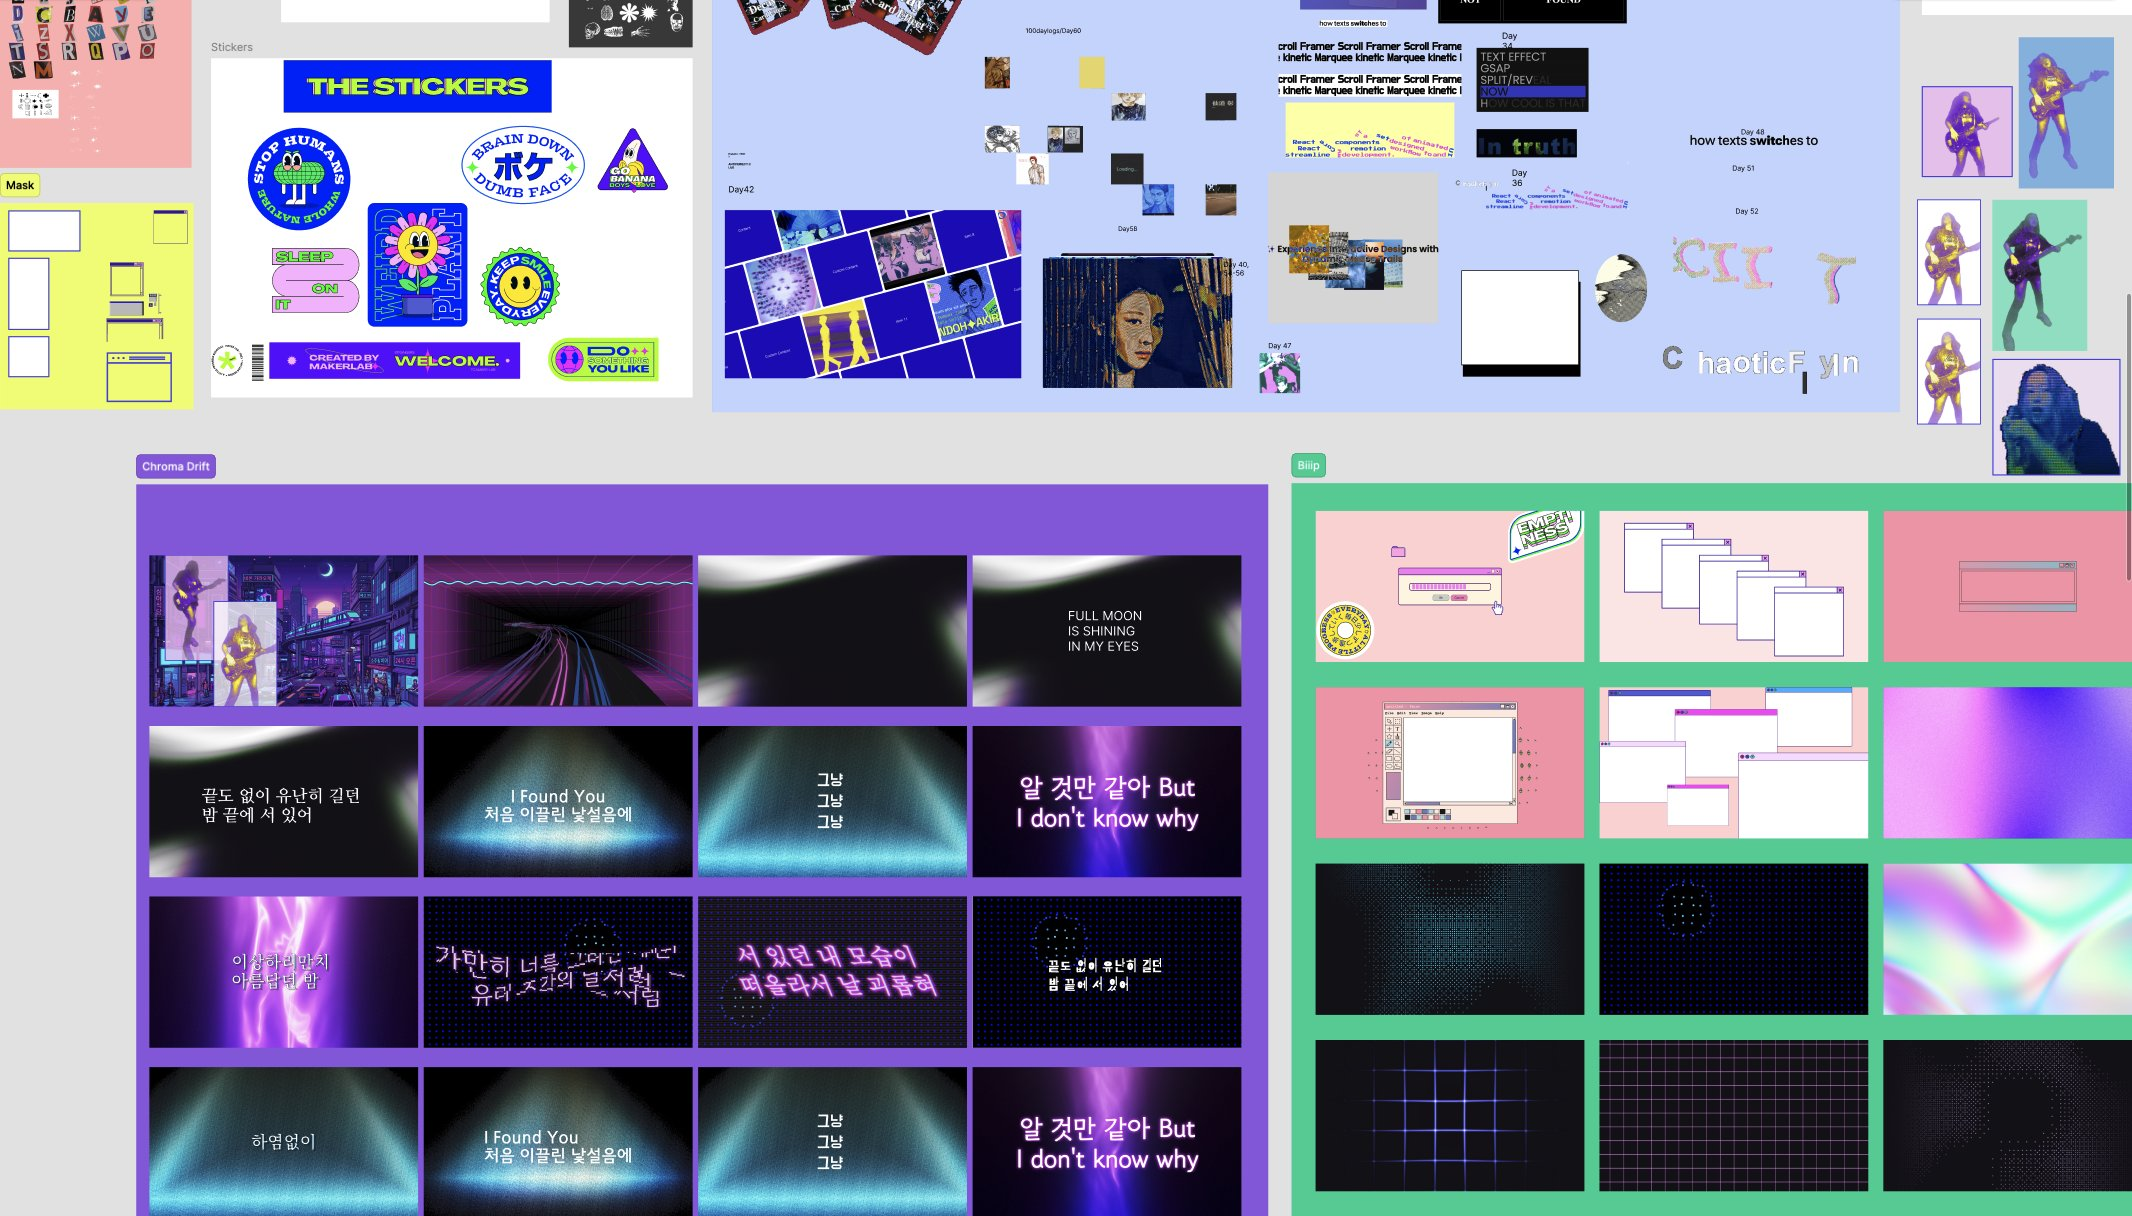
1920×1080 프레임 안에 컴포넌트 카탈로그의 스틸컷을 나열하고, 기존 웹 컴포넌트에서 추출한 SVG와 PNG 애셋을 다시 조합했다.
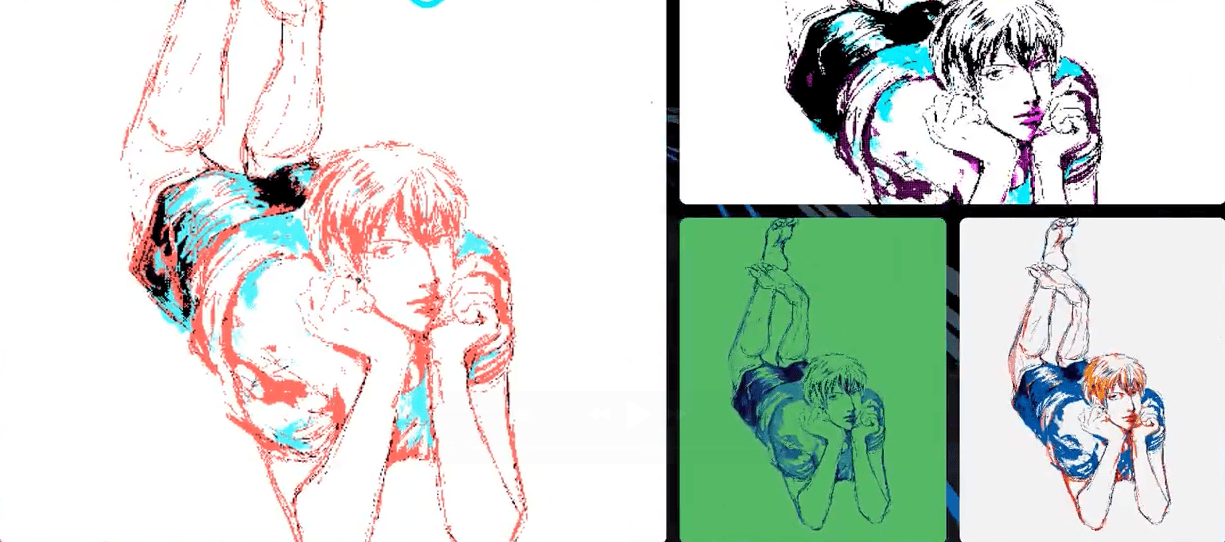
몬드리안 스타일의 그리드 레이아웃.
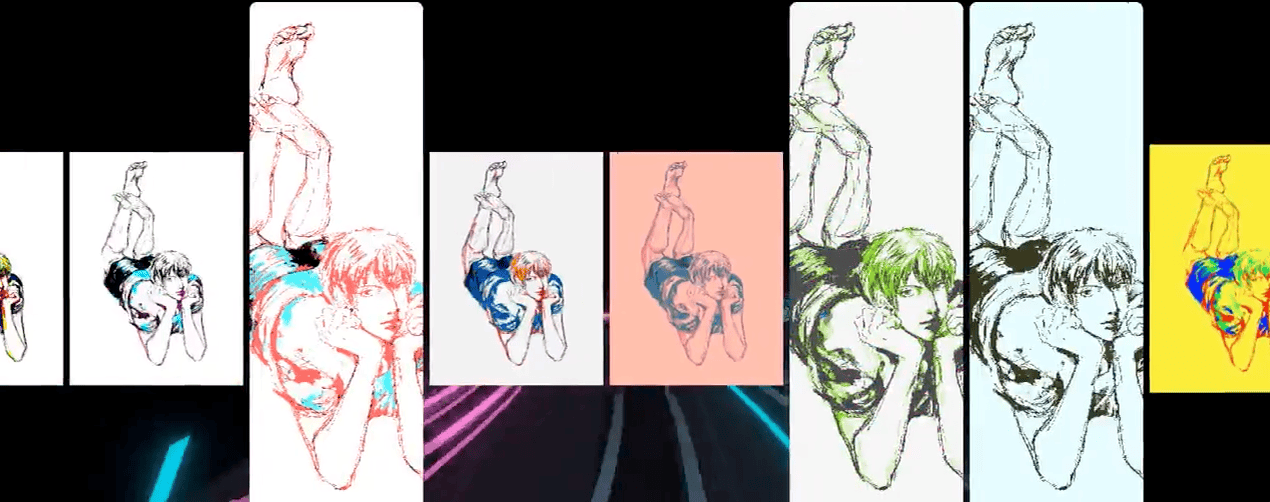
슬라이딩 카루셀과 아코디언 애니메이션.
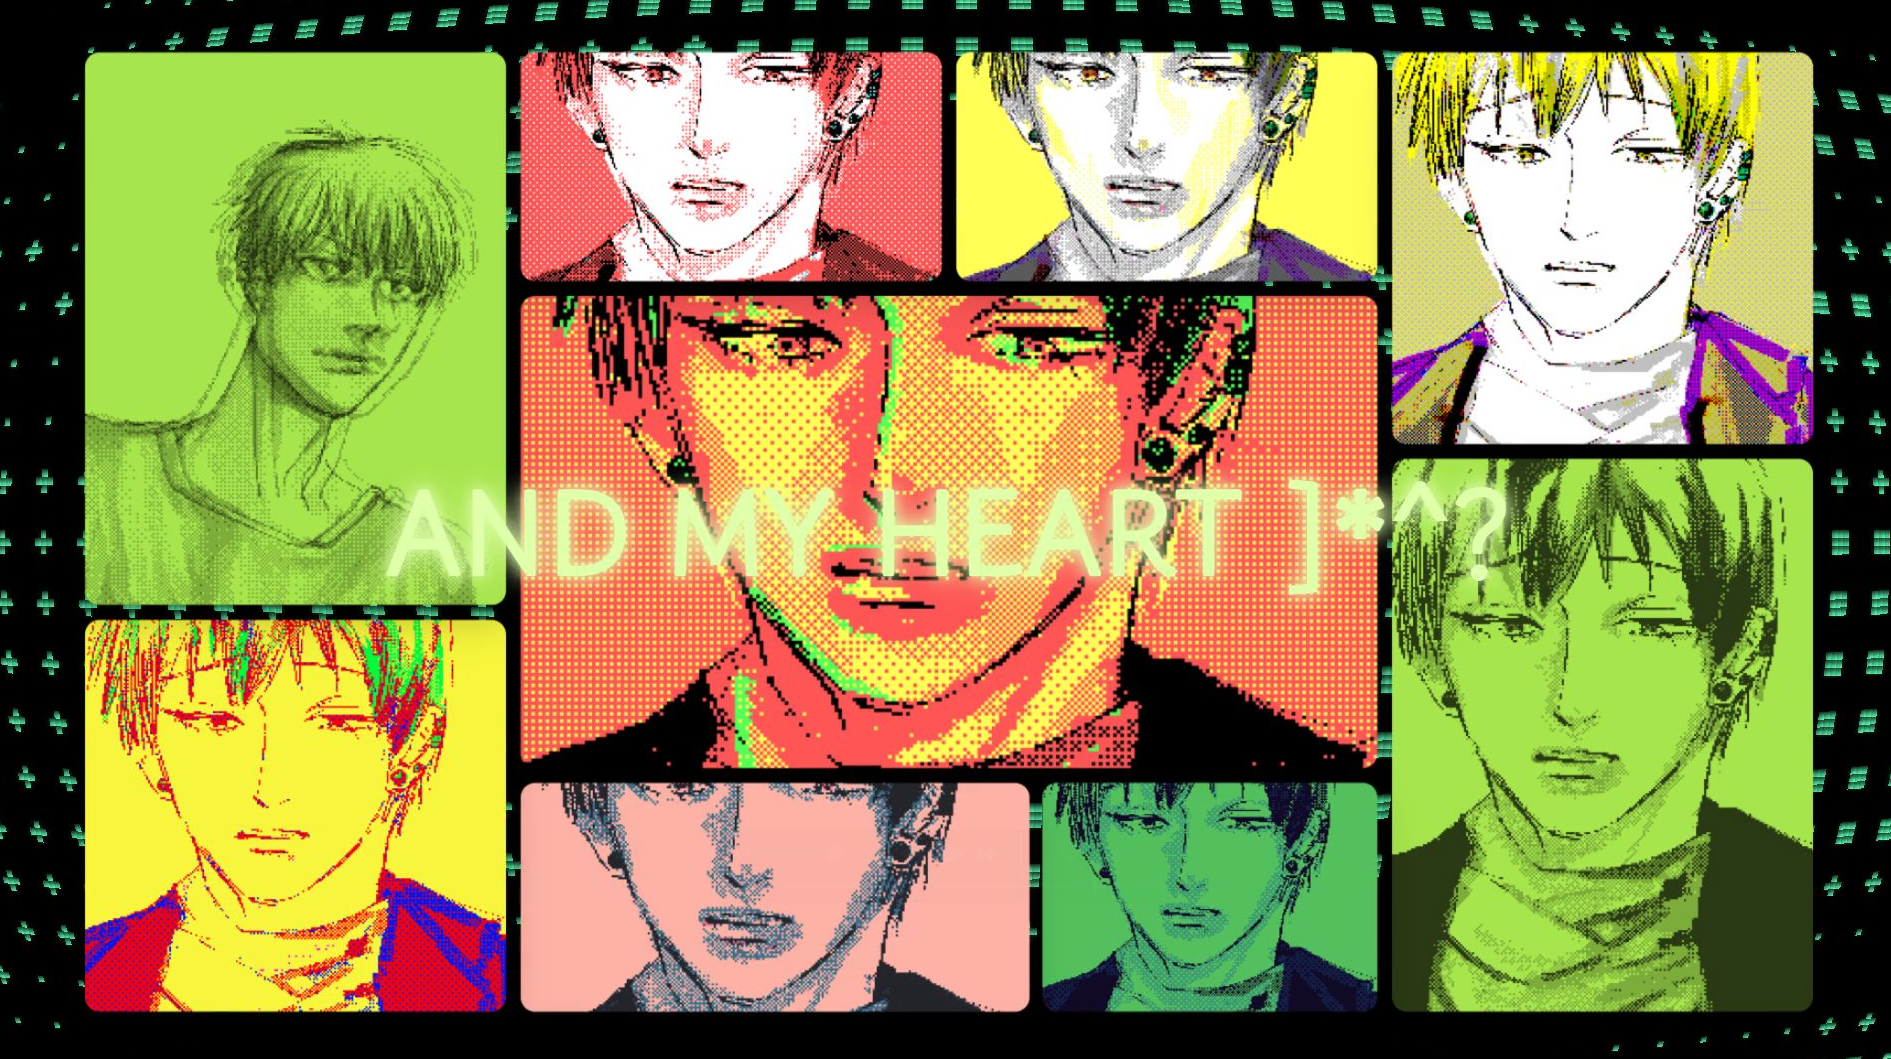
Bento Grid 기반의 스틸샷.
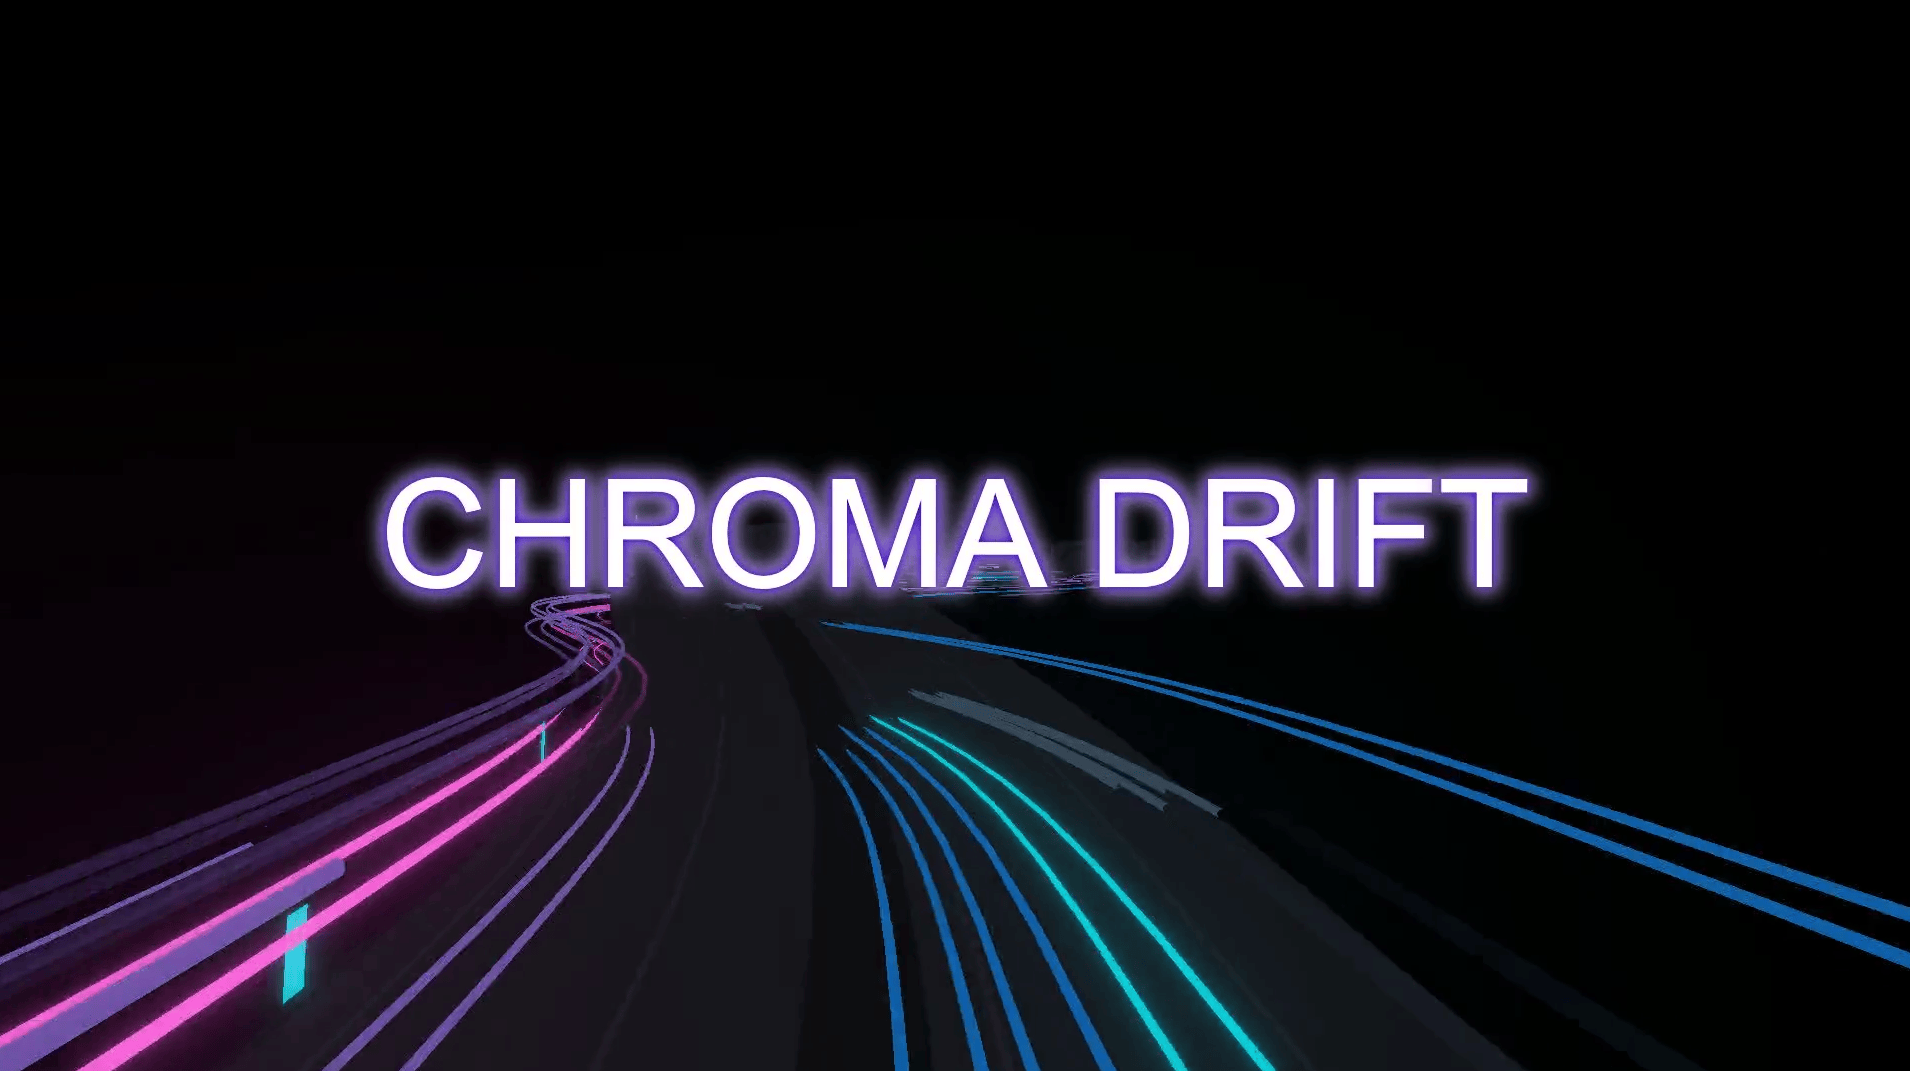
WebGL 시티팝 네온사인 테마의 고가도로 위에 글로우 텍스트를 배치했다.
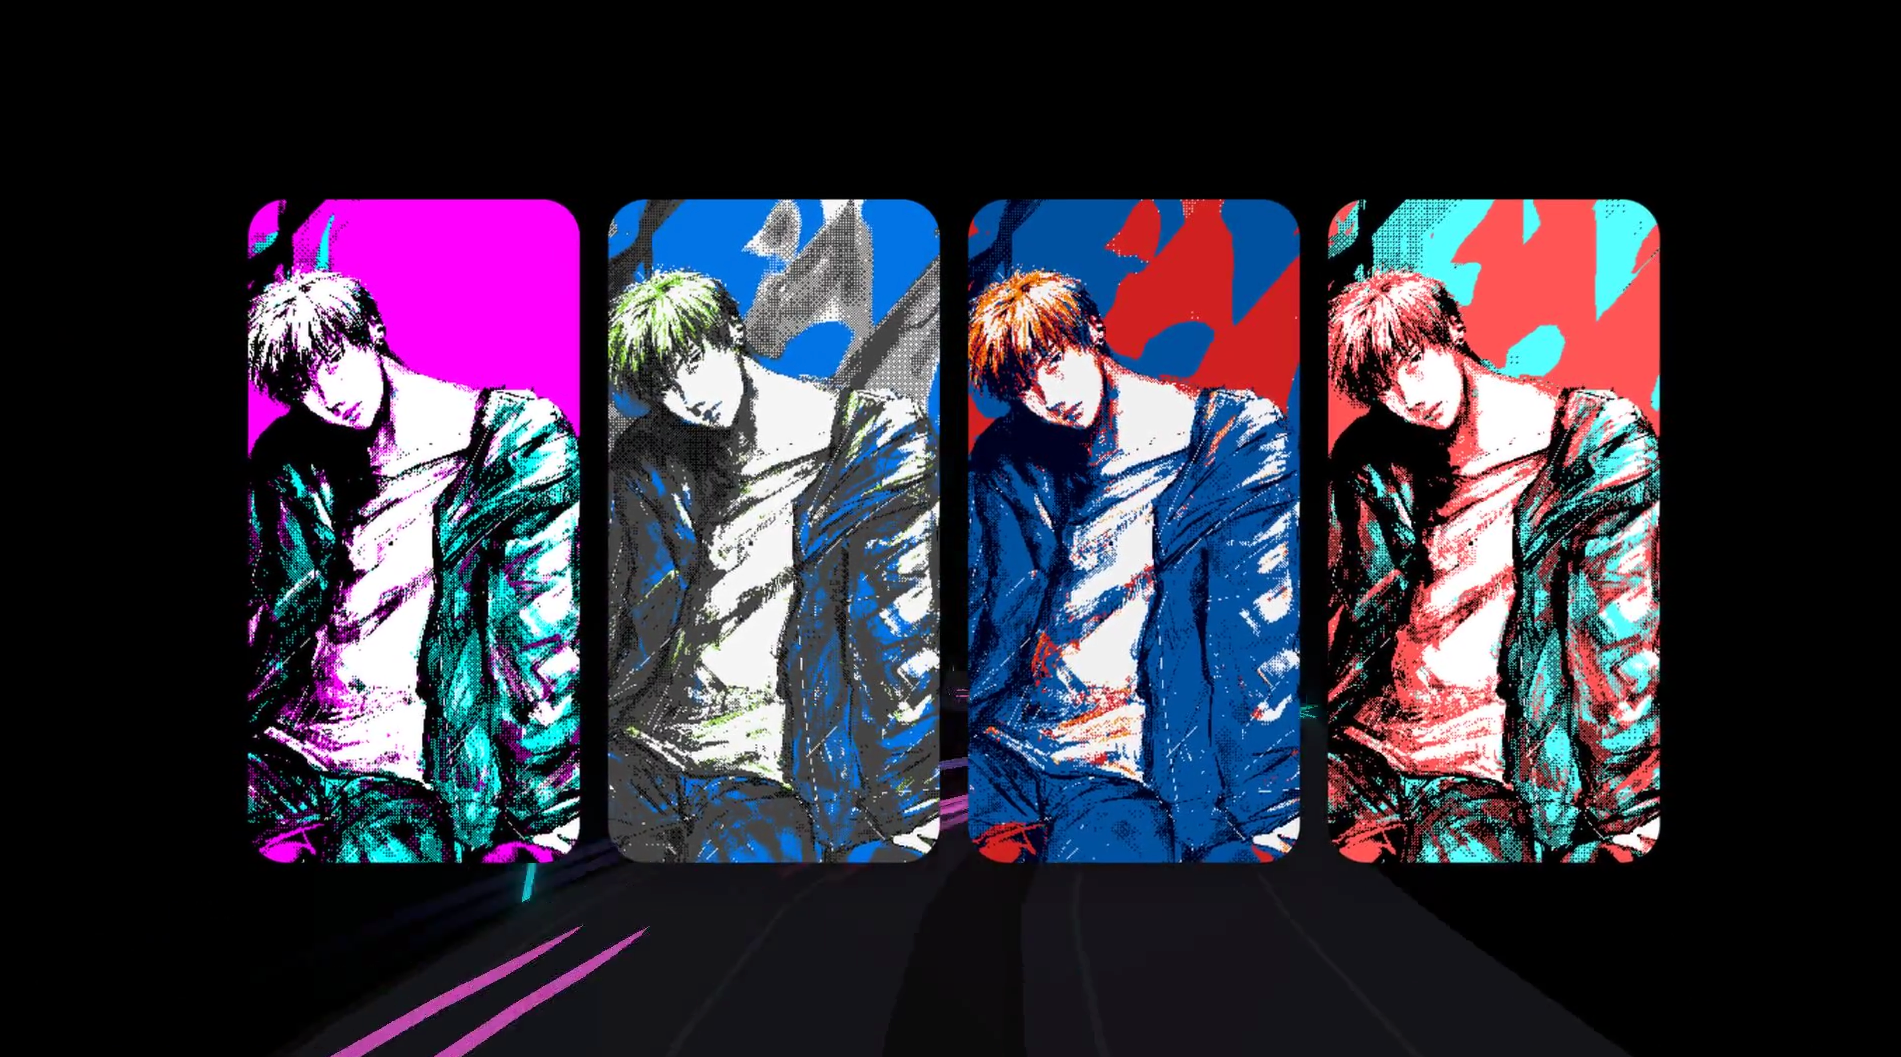
타이포그래피가 끝난 뒤 이미지가 슬라이드로 차례대로 등장하는 구조.
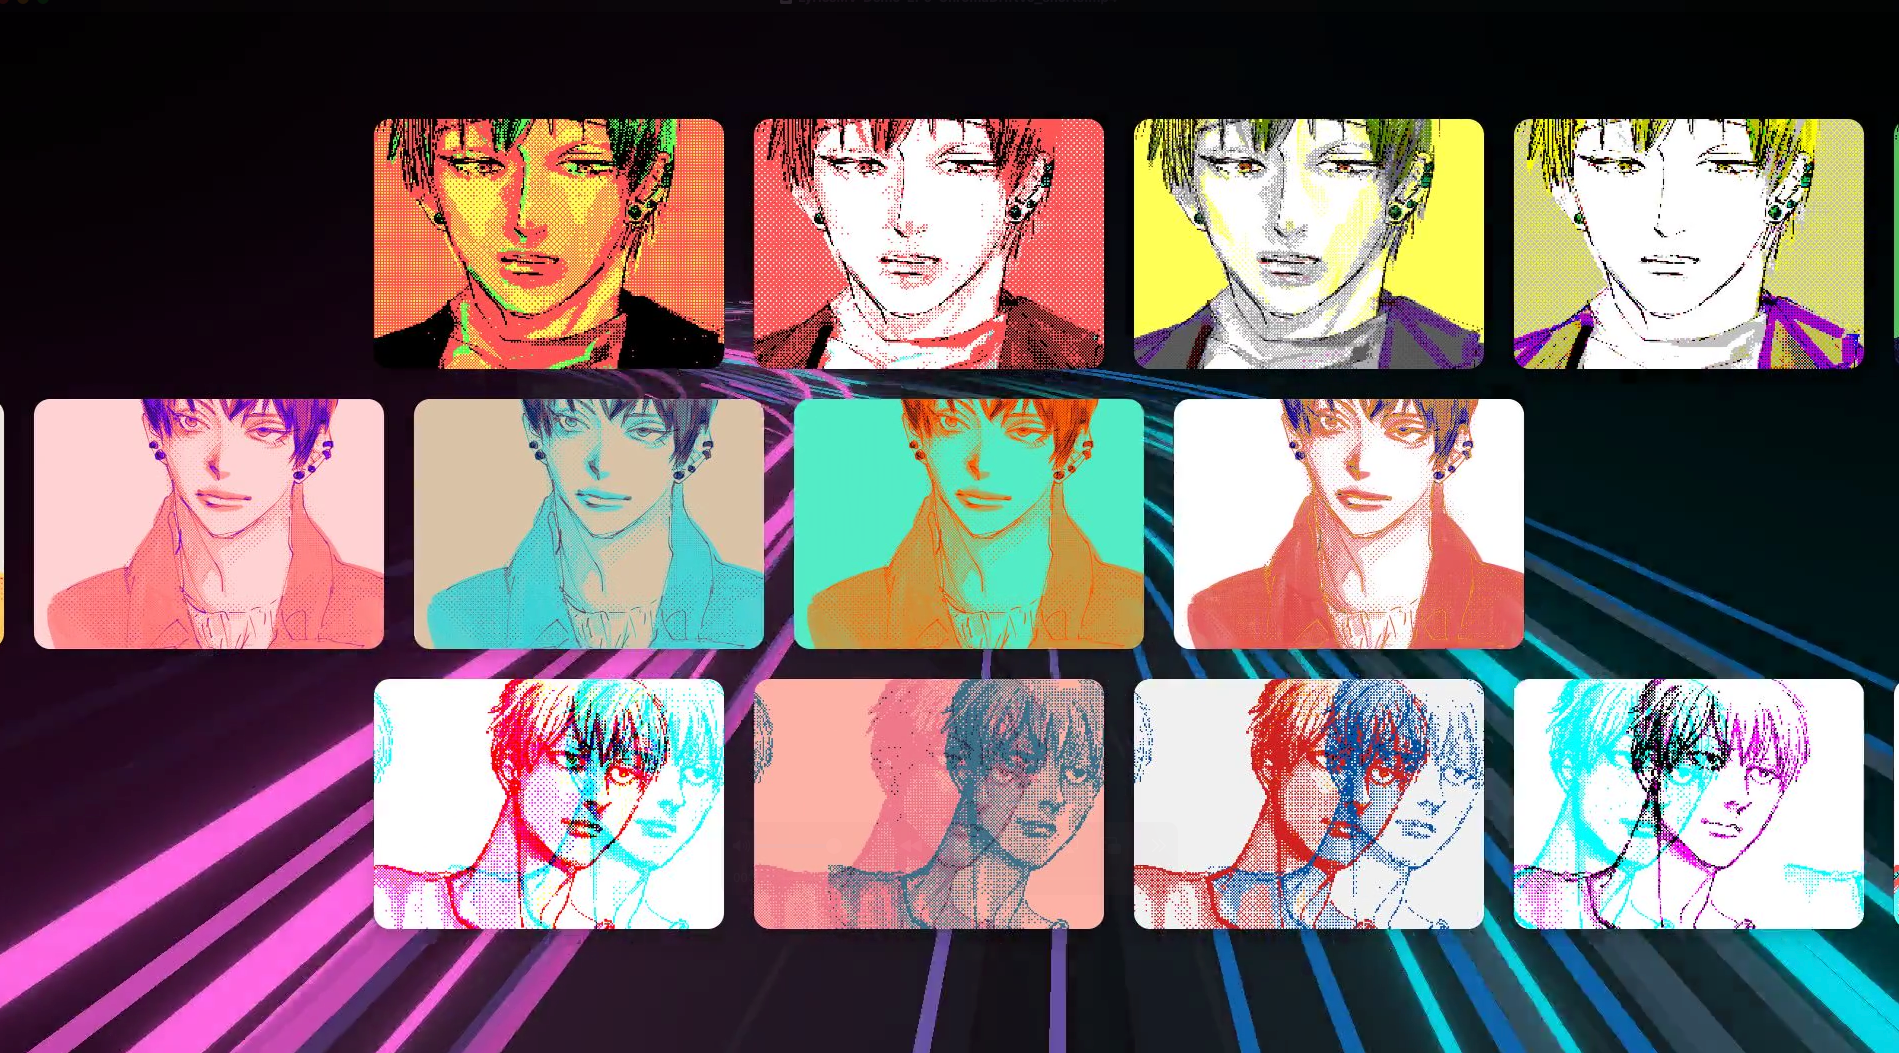
여러 도면 패널과 레이아웃 블록이 차례로 등장하는 장면.
타입 믹스 툴도 별도로 만들었다. 다만 여러 프리셋을 범용적으로 조립하는 부분은 아직 애매해서 잠시 파킹했다. (완성되지 않은 시스템을 완성된 척 포장하는 것보다는 솔직한 편이 낫다.)
7. Niji: 오디오, 서사, 화면의 오케스트레이션
2026년 5월부터 6월까지 진행한 Niji는 지금까지 쌓아온 모든 작업을 한곳에 모은 프로젝트였다. 원곡은 L’Arc-en-Ciel의 「Niji」이며, 나는 직접 커버 보컬을 녹음하고 그 감정선에 맞춰 영상을 구성했다.
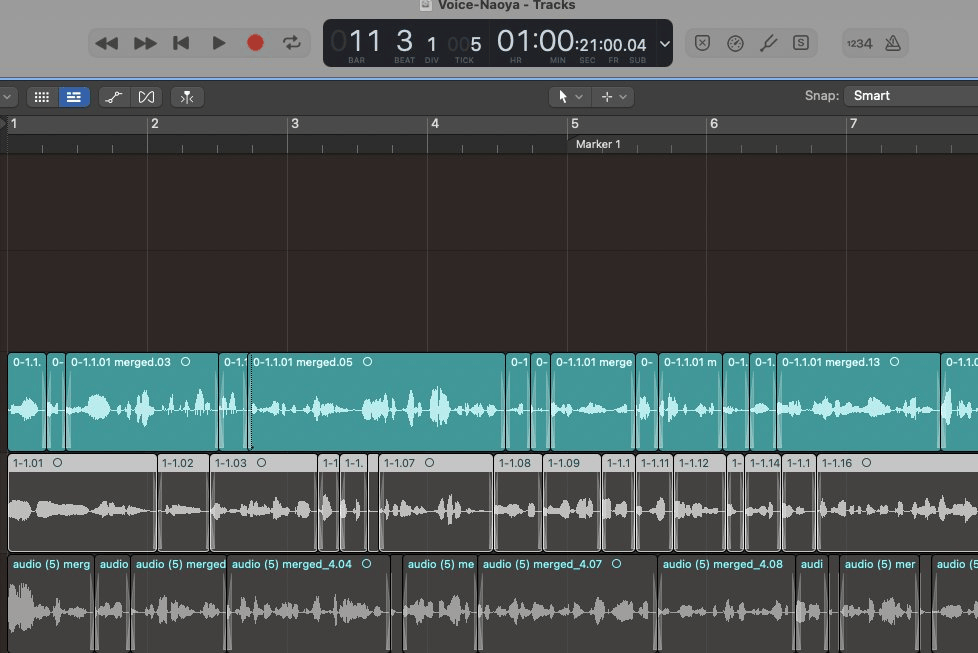
녹음 파일을 정리하고 노이즈를 제거한 뒤, RVC 학습 데이터셋에 사용할 샘플을 편집했다.
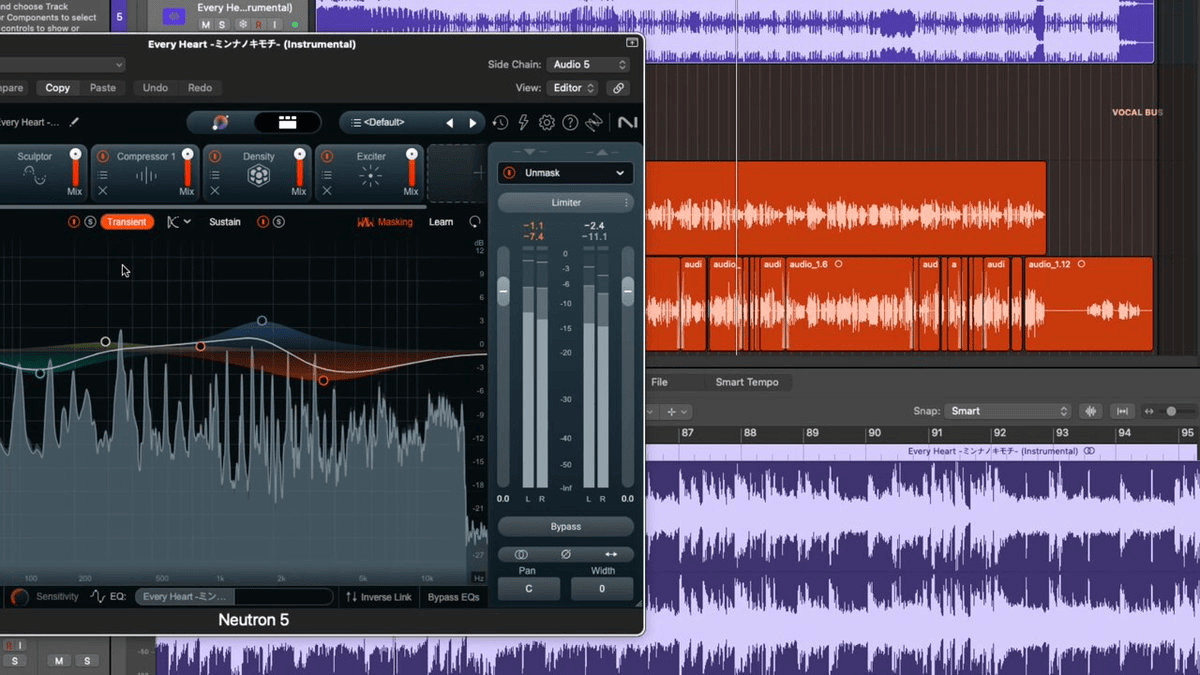
Logic Pro와 Reaper에서 Melodyne, EQ, Compressor를 조정하며 보컬을 MR 안에 녹여냈다.
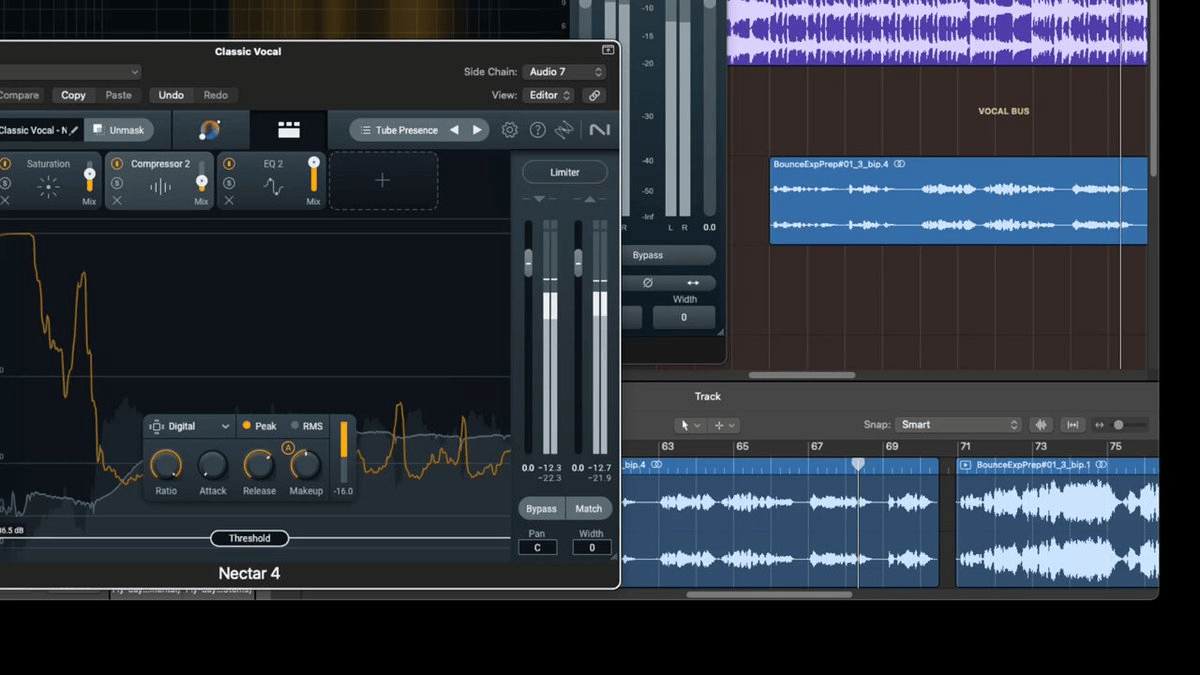
믹싱과 마스터링은 끝이 보이지 않는 모니터링의 연속이었다. 오디오가 어설프면 화면을 아무리 까리하게 뽑아도 전체 밸런스가 무너진다.
보컬 녹음과 믹싱 과정은 KR-the-journey-of-audio-recording-mix-audio-composition에, 피치 및 보컬라인 분석은 KR-the-journey-of-audio-vocalign-analysis에 정리해두었다.
오디오 스펙트럼의 에너지 피크는 Reaper에서 마킹하고 CSV로 추출했다. 이 데이터는 나중에 애니메이션 이벤트와 연결된다. 비트가 터지는 순간 이미지가 바뀌고, 특정 음절에서 글자가 수렴하며, 특정 프레임에서 블렌딩 모드가 전환된다.
Niji의 기술 구성
[[ 2025-07-22-Project-Virtual-Idol-Podcast ]]에서 추출한 자막 처리 경험을 바탕으로 SRT 데이터를 Remotion에 연결했다.
첫 번째 리릭스 비주얼라이저는 Niji 아키텍처의 출발점이었다.
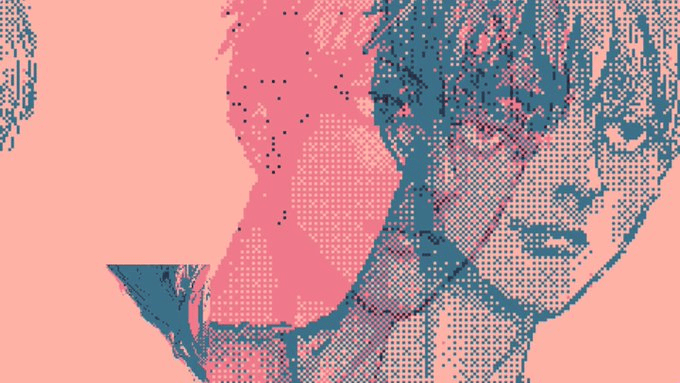
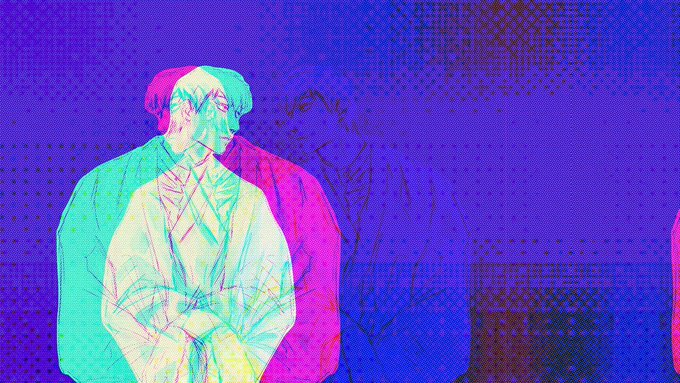
Texture Mix와 WebGL VGA Tool을 사용해 일러스트에 거친 디스토피아적 질감을 입혔다.
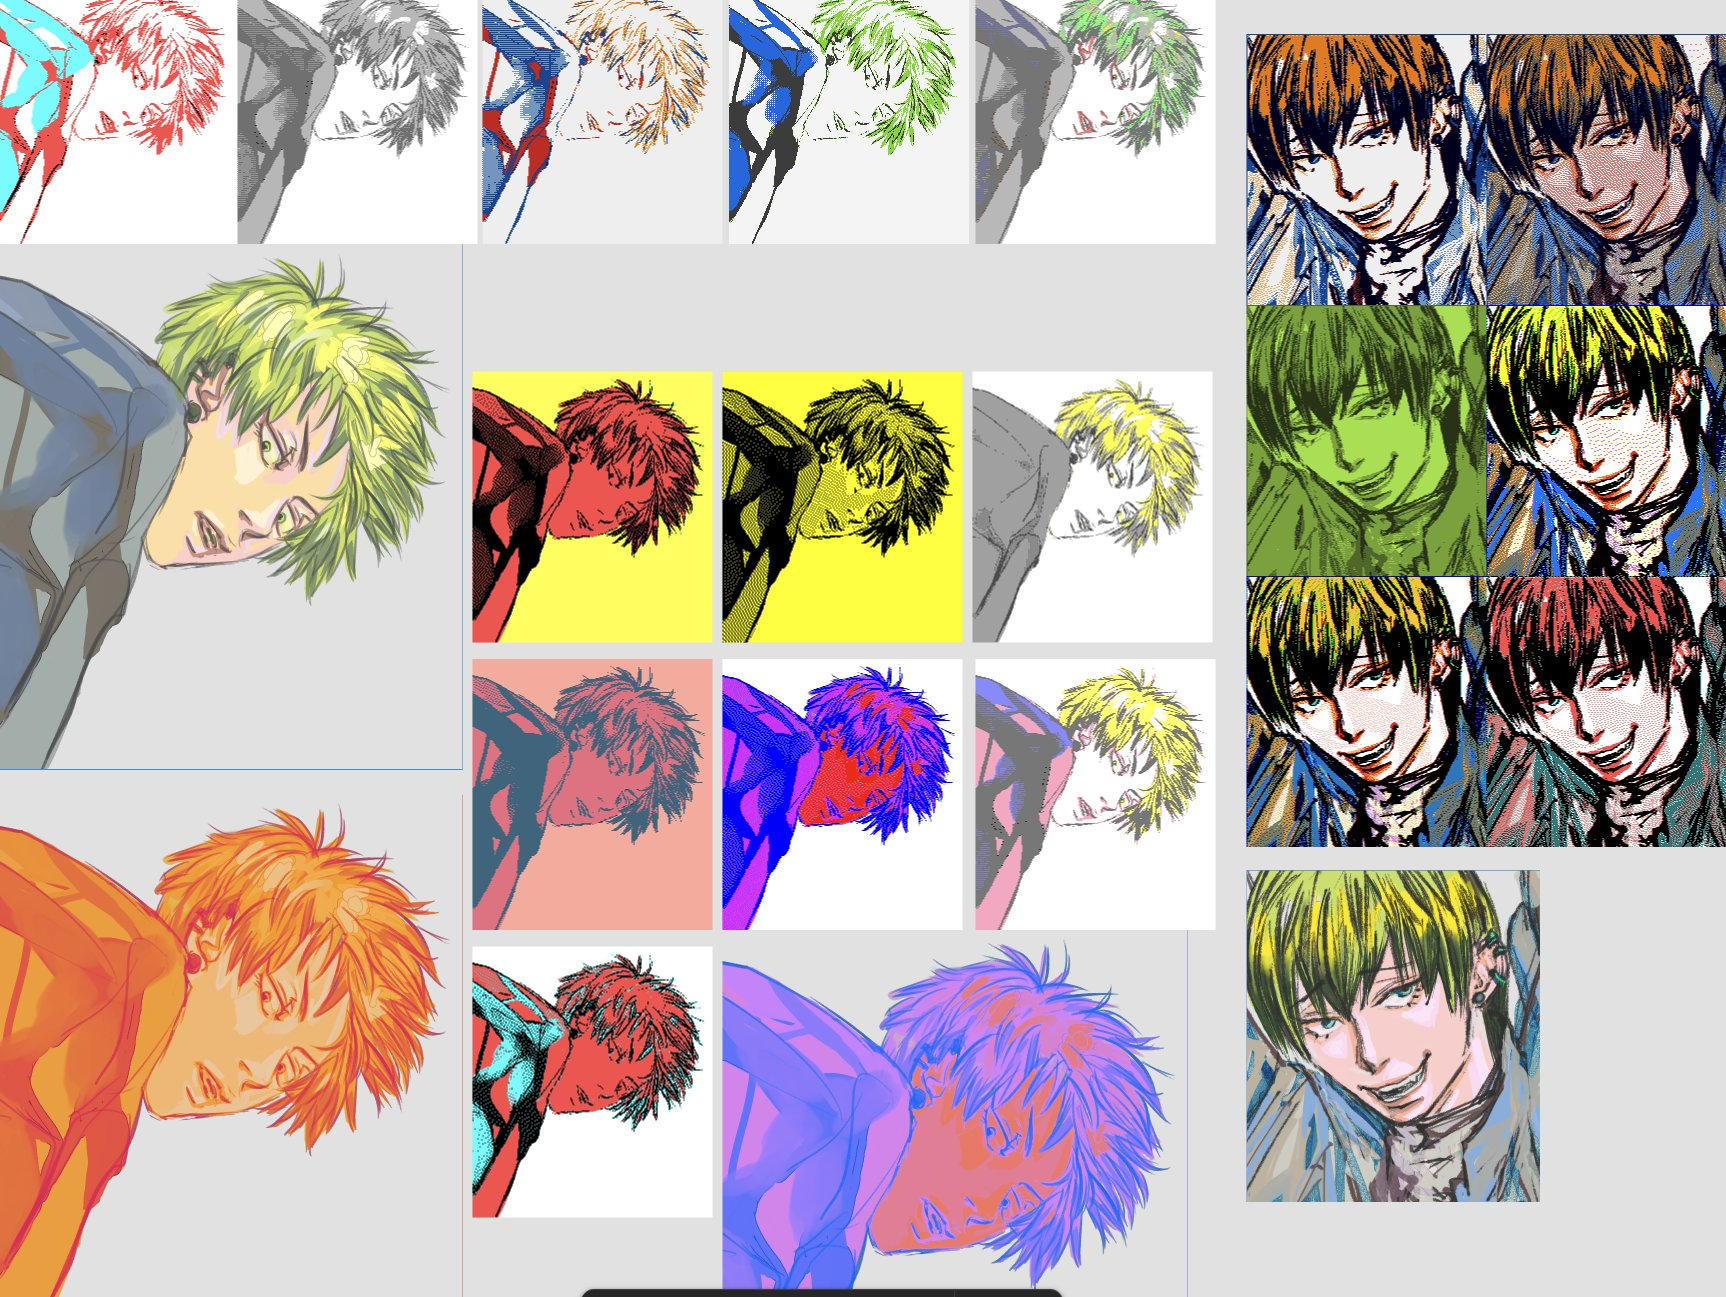
Dithering과 Glitch를 중심으로 컬러셋을 구성했다.
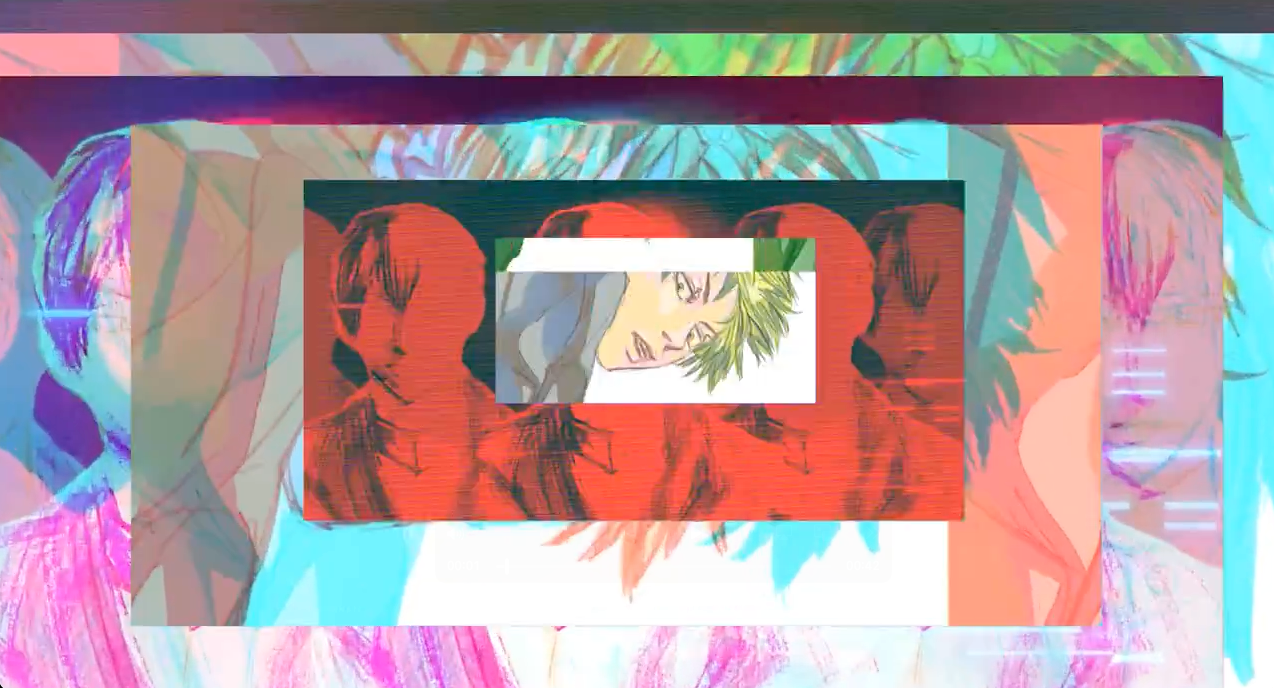
CSS3 Blending Mode를 조합해 레이어가 겹치는 순간의 시각적 변화를 사전 검증했다.
모션 그리드 블록의 레이아웃과 등장 순서를 설계했다.
Biiip-!, BTTF, Chroma Drift의 프로토타입 경험을 Niji 전용 스토리보드로 재조립했다.
Remotion에 바로 바인딩할 수 있는 Google Fonts 프리셋을 정리했다.
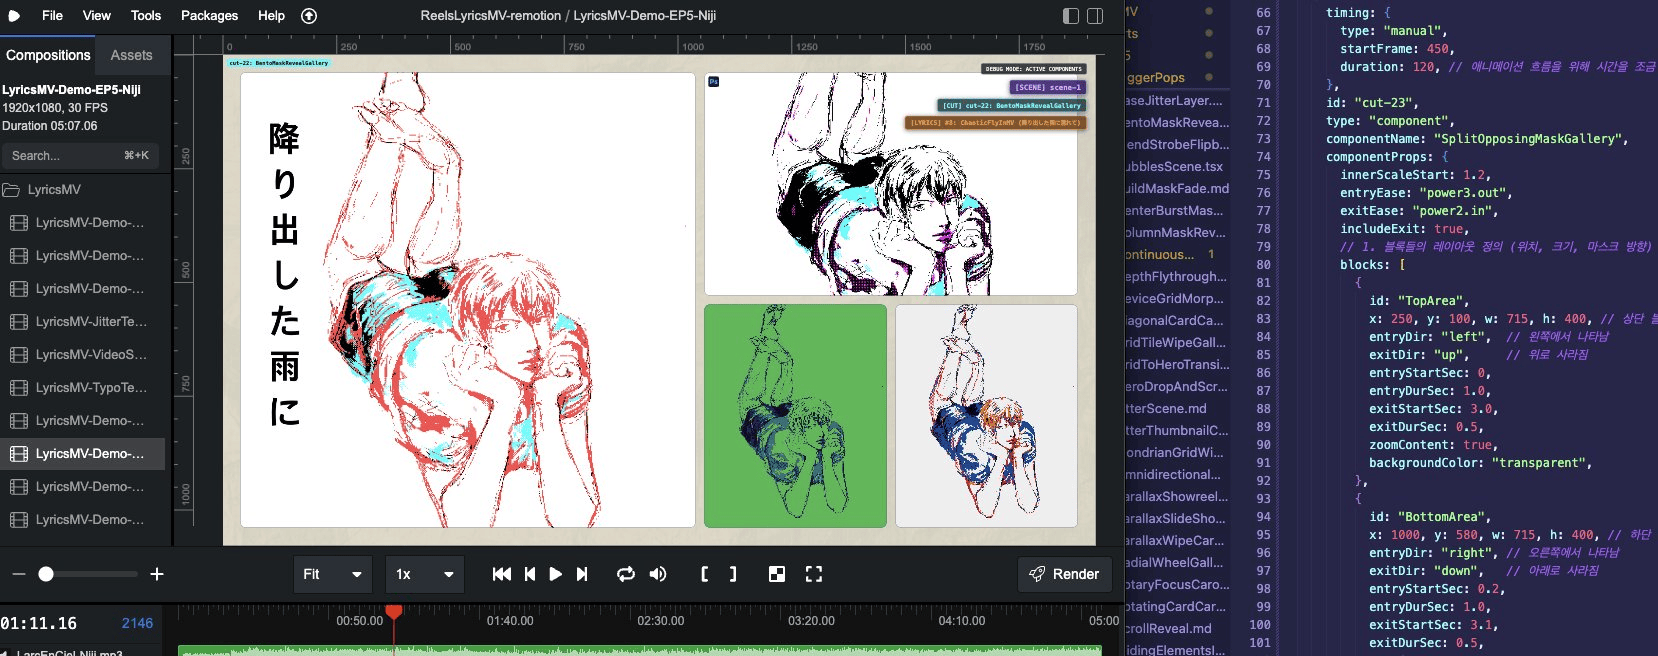
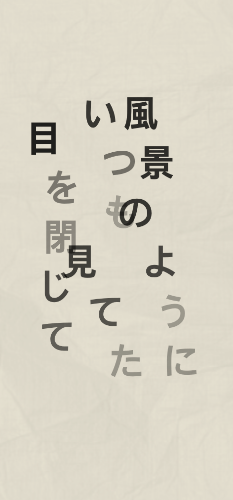
가장 지독했던 작업은 Accelerated Letter-Spacing Debugging(가속 자간 디버깅) 이었다. 글자 하나하나가 서로 다른 속도와 밀도로 흩어졌다가 보컬 타이밍에 맞춰 문장으로 수렴해야 했다.
5분이 넘는 곡 전체에 대해 자간, 글자별 디스플레이 타임, 가로·세로 레이아웃, 타이밍 딜레이를 프레임 단위로 조정하는 일은 거의 수공업이었다.
8. 서브컬처 서사와 비주얼 디렉팅
기술이 뼈대라면 서사는 화면에 피를 돌게 한다.
Niji에서는 주술회전의 젠인 토우지와 젠인 나오야의 관계를 팬의 시점에서 재해석했다. 주술계의 굴레를 거부한 자와, 그 굴레의 최상단에서 인정받기를 원하다가 무너진 자의 관계를 곡의 감정선과 연결했다.
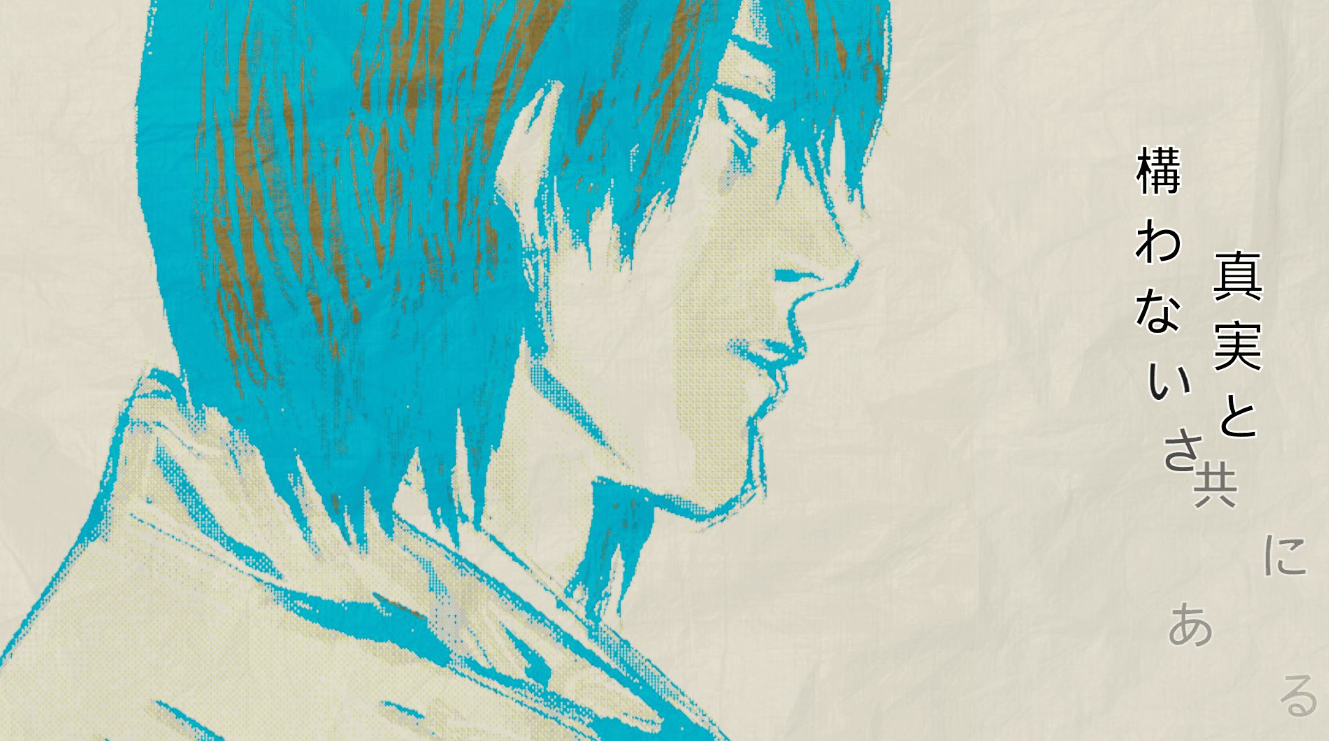
CSS3 saturation과 blend 필터를 전체 컷에 적용하고, 가사가 불리는 정확한 오디오 타임코드에 맞춰 레이아웃을 반응시켰다.
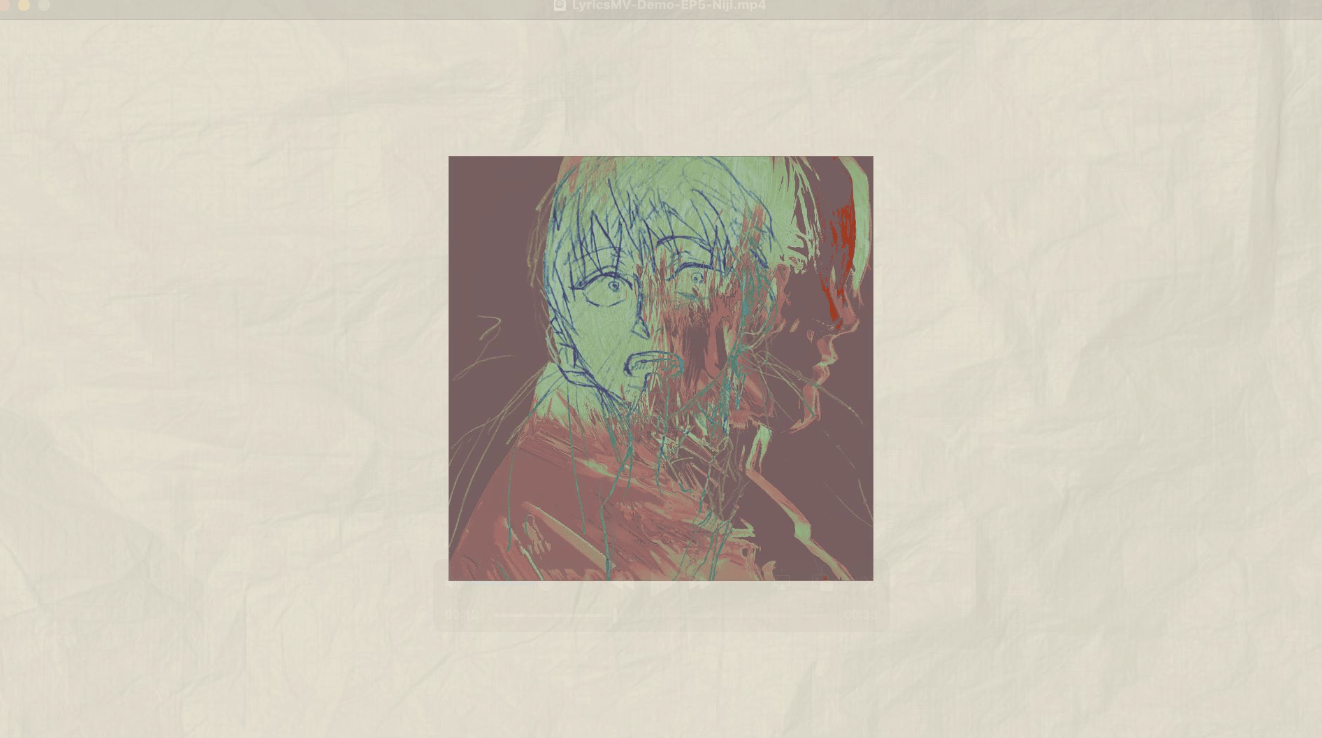
여러 일러스트 레이어를 중첩하고 기하학적 블렌딩 모드를 교차시켜 인물의 내면적 혼란을 표현했다.
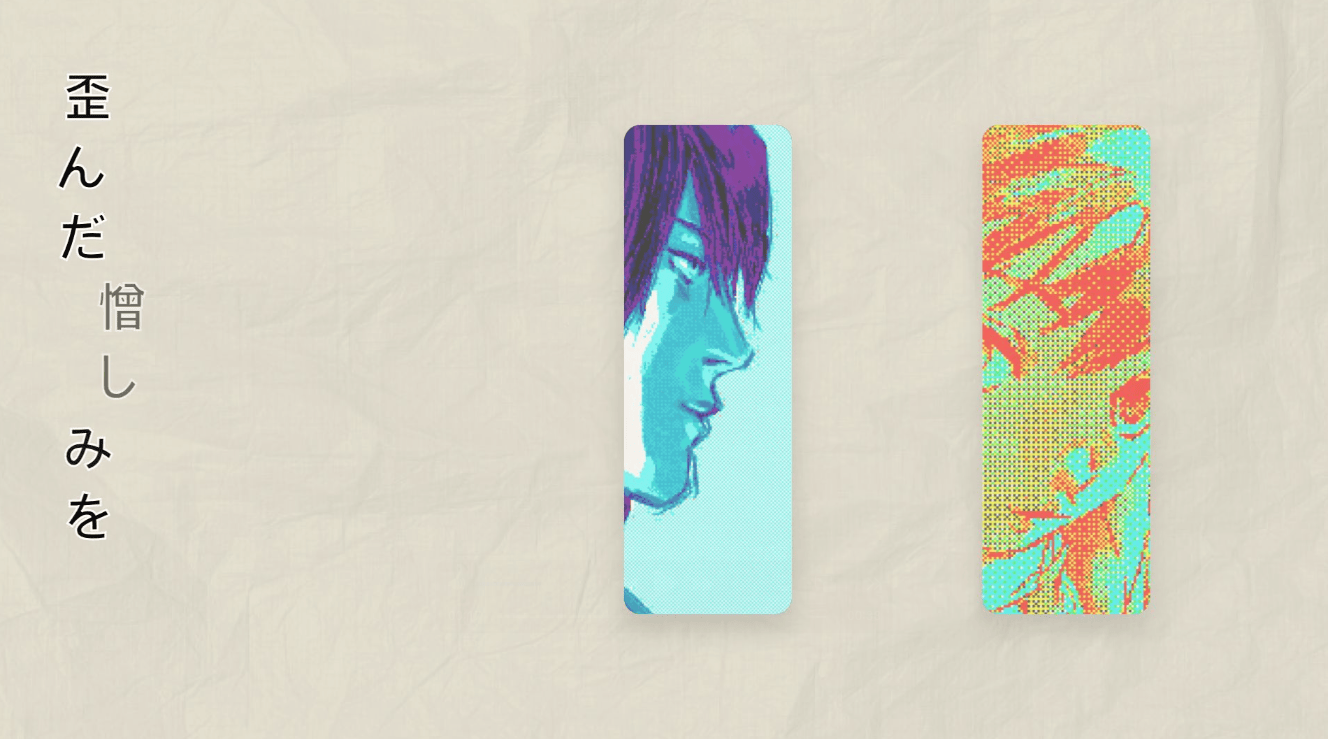
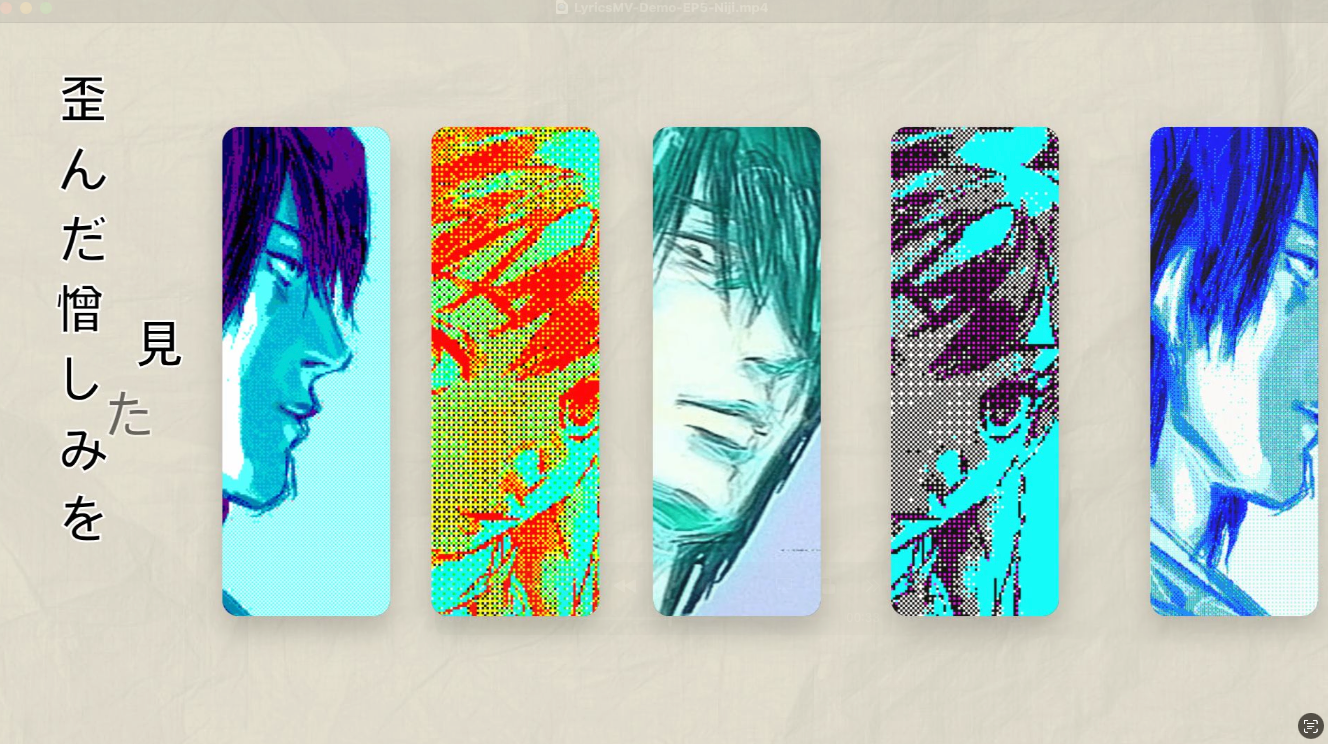
서로 다른 속도의 블록이 슬라이딩으로 진입한 뒤 한 프레임 안에서 수렴하도록 구성했다.
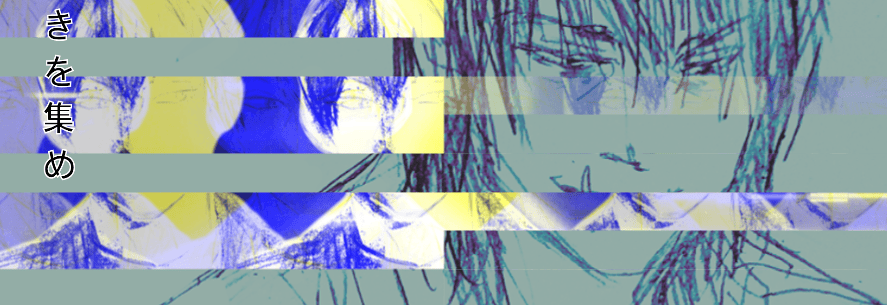
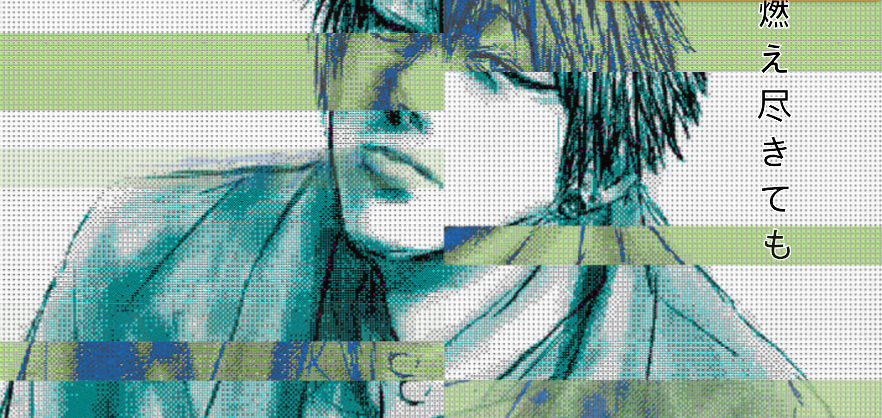
이미지와 컬러 블록을 일그러뜨리고 마스크 패스를 가변적으로 제어해 몬드리안 그리드가 파열되는 듯한 구조를 만들었다.
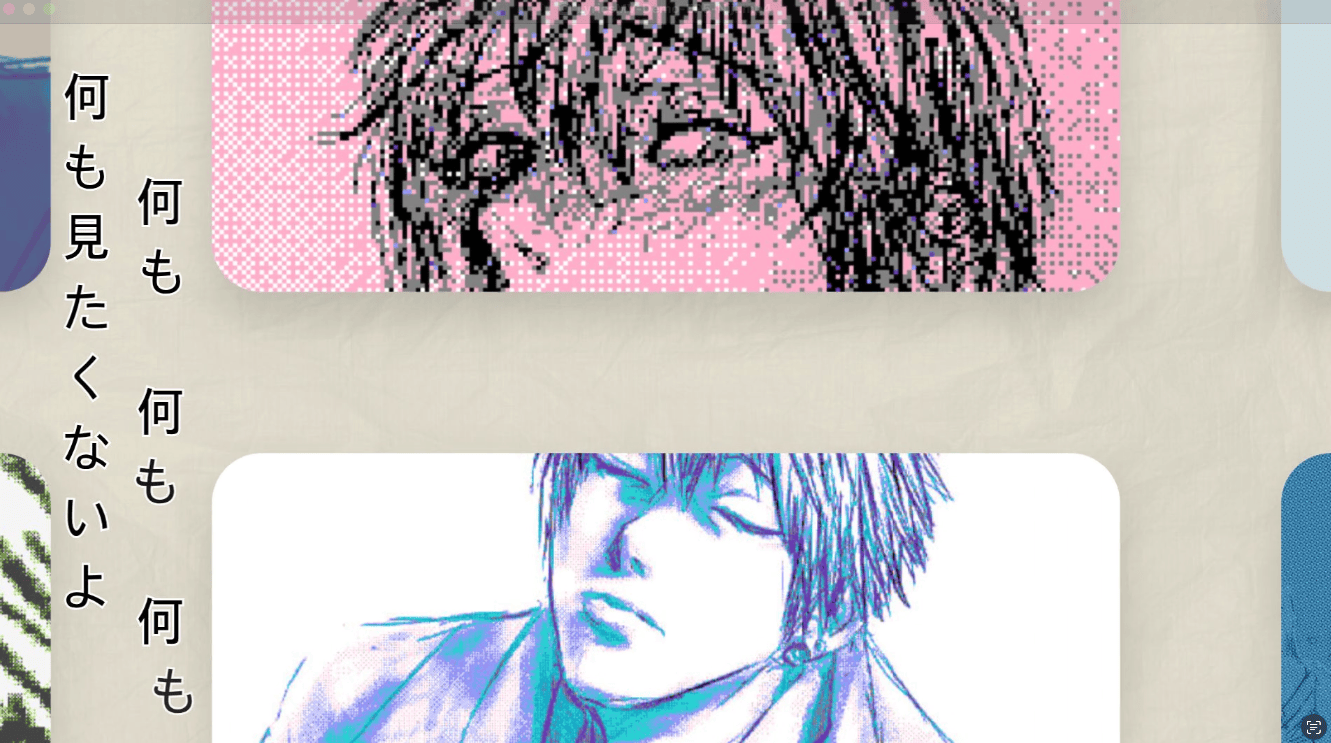
Swipe Roll과 Hero Carousel 방식의 줌인·줌아웃 프레임을 적용했다.
여기서 중요한 건 캐릭터 이미지를 예쁘게 배치하는 일이 아니었다. 어떤 감정을 어느 프레임에 배치하고, 어떤 가사와 어떤 색상, 어떤 노이즈를 결합할 것인지 결정하는 일이었다.
9. AI, Constraint, 그리고 인간 디렉터
AI 에이전트에게 “Remotion에서 알파 WebM 비디오 여러 개를 Stagger 처리하고 메모리 누수를 줄여줘”라고 요청하면 코드는 아주 당당하게 나온다.
문제는 그 코드에 존재하지 않는 훅이 들어가거나, WebGL Context를 강제로 삭제해 브라우저 탭을 얼려버리는 일이 생긴다는 것이다. AI가 만들어낸 환각 코드 하나를 믿고 3일을 날린 뒤, 결국 useCurrentFrame()과 프레임 상태를 직접 추적하는 순수 React 라이프사이클 코드로 되돌아왔다.
도메인 전문가가 AI를 사용할 때의 역설은 이렇다.
- 환각을 막기 위해 Constraint와 Scope를 먼저 정의한다.
- WebGL 성능, Remotion 프레임 스킵, 오디오 Phase 문제를 API Spec으로 문서화한다.
- 그 정도로 상세하게 명세할 바에는 내가 직접 짜는 편이 백배 빠르다는 결론에 도달한다.
AI는 반복 작업을 줄이는 도구로는 유용하다. 하지만 무엇을 만들지, 어떤 감정을 전달할지, 어떤 렌더링 제약을 감수할지 결정하지는 못한다.
그 판단은 결국 인간 디렉터의 몫이다.
10. 작업별 아키텍처 정리
| 작업 | 도입 방식 | 아키텍처 / 기술 |
|---|---|---|
| 첫 번째 Lyrics Visualiser | 기존 웹 애니메이션을 Remotion으로 이식 | React, TypeScript, Remotion, SVG, CSS3 |
| Chroma Drift | 보컬 커버와 기존 비주얼라이저의 재스킨 | Logic Pro, Reaper, Melodyne, WebGL, SRT |
| Niji | 음악·서사·그래픽·코드의 통합 | Remotion, Whisper, Python, CSV, WebGL, SVG Filter |
| Motion CX Journey System | 반복되는 모션을 토큰과 카탈로그로 패턴화 | Figma, Wireframe, Motion Token, Component Catalog |
| Background Maker | 셰이더 파라미터를 GUI에서 탐색 후 schema화 | GLSL, Three.js, React Three Fiber, WebGL |
| Texture Mix | 이미지와 셰이더 레이어를 조합 | Vertex Shader, Fragment Shader, Noise, VHS Texture |
| Kinetic Typography | SRT와 프레임 타임라인을 기반으로 글자별 제어 | TypeScript, CSS Variables, interpolate()
|
| 오디오 연동 | 에너지 피크와 타임코드를 애니메이션 이벤트로 변환 | DSP, Python, Reaper, CSV |
| 리팩토링 | GSAP과 Remotion의 책임 분리 | GSAP Layer, Remotion-native _motion/ Layer |
11. 함께 축적된 작업 자산
효과와 키네틱 타이포그래피를 미리보기 위해 만든 자체 제작툴:
KR-my-own-production-tool-bg-maker
KR-my-own-production-tool-texture-mix
브랜딩 아이덴티티와 시각 미학을 구축한 과정:
KR-developing-my-own-aesthetics
커버 MV 작업 과정:
KR-my-first-lyrics-visualiser-mv
KR-the-second-version-trial-lyrics-visualiser-chroma-drift
KR-the-complete-lyrics-visualiser-mv-niji
KR-KR-the-stopmotion-cut-trial-mv-the-hardest-button-to-button
오디오와 인터랙티브 미디어 기반 작업:
KR-GameToAudioDesign
KR-Audio-to-Chart Pipeline
KR-the-journey-of-audio-vocalign-analysis
KR-the-journey-of-audio-recording-mix-audio-composition
KR-K-Pop-Live-Band-Rework
KR-how-1-person-can-make-diverse-charactor-acting-for-audio-drama
모션 그래픽스와 Remotion 기반 작업:
KR-remotion-gsap-pros-and-cons
KR-figma-to-jitter-and-remotion
KR-remotion-and-shader-converting-glsl-to-webgl
KR-making-first-time-youtube-vid-with-remotion
KR-how-i-make-a-youtube-series-with-remotion-dynamic-srt-script-setup-exp-likejennie
KR-how-i-made-podcast-interview-with-ai-virtual-idol
KR-how-my-motion-graphics-workflow-has-been-evolved
에필로그: 결국 남는 것은 디렉팅
5분 남짓한 Lyrics MV 하나를 만들기 위해서는 다음의 과정이 모두 필요했다.
- 보컬 녹음과 노이즈 제거
- Python 기반 피치 분석
- RVC 학습과 파라미터 검토
- Logic Pro와 Reaper를 통한 수동 보정
- 믹스와 마스터링
- Whisper 기반 SRT 생성
- Remotion과 TypeScript 기반 컴포지션
- WebGL과 GLSL 셰이더 구현
- SVG Filter와 CSS3 Blending
- Figma 스토리보드와 모션 토큰
- 서브컬처 서사와 캐릭터 디렉팅
- 프레임 단위 디버깅과 렌더링 검증
이 중 하나라도 빠졌다면 결과물은 단순한 템플릿 영상에 머물렀을 것이다.
중요한 건 기술을 많이 썼다는 사실이 아니다. 현장의 제약 조건을 이해하고, 오디오와 영상의 맥락을 통제하며, 필요한 순간에 직접 구조를 다시 설계할 수 있었다.
결국 복잡한 창작 파이프라인을 완성하는 것은 버튼 하나가 아니다. 현장의 제약 조건을 이해하고 맥락을 통제하는 도메인 전문가, 즉 인간 디렉터의 판단이다.
그리고 다음에는 The White Stripes의 「The Hardest Button to Button」 커버작에서 소리와 비주얼, 코드가 또 한 번 개같이 굴러가며 만날 예정이다.
일단 드럼부터 고쳐야 하지만…아이고 내 팔자야.